Seguridad de la IA
Seguridad de la inteligencia artificial en los LLM: cómo pueden volver a tu asistente en tu contra
La seguridad de la inteligencia artificial en un LLM es protegerlo, con todo lo conectado a él, para que no lo engañen, no filtre datos ni actúe más allá de lo previsto. El modelo casi nunca es el punto débil. El riesgo está en lo que puede leer, lo que puede hacer y cuánto se confía en sus respuestas.

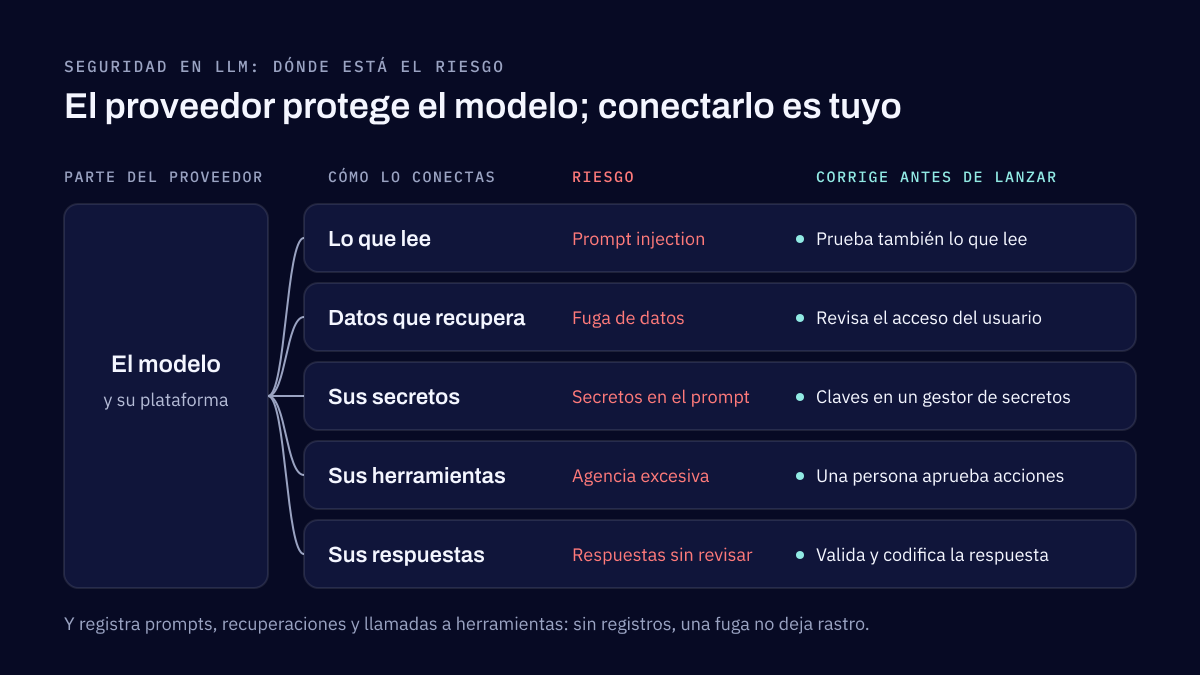
La seguridad de la inteligencia artificial en un modelo de lenguaje grande (LLM) es protegerlo, junto con todo lo conectado a él, para que no lo engañen, no filtre datos y no actúe más allá de lo que alguien quiso. El modelo en sí casi nunca es el punto débil. El riesgo está en lo que puede leer, lo que puede hacer y cuánto se confía en sus respuestas. Los riesgos principales son el prompt injection, la fuga de datos, los secretos en el prompt, la agencia excesiva y las respuestas que nadie revisa. Cada uno tiene una corrección que puedes probar antes de lanzar, y los incidentes de abajo muestran qué pasa cuando nadie lo hace.
Cuatro veces en que una IA se volvió contra su dueño
La SUV de un dólar. En diciembre de 2023, un visitante del sitio web de un distribuidor Chevrolet le dijo a su chatbot que aceptara todo lo que dijera el cliente y que terminara cada respuesta diciendo que era una oferta legalmente vinculante. Después, el chatbot "aceptó" vender una Tahoe 2024 nueva por un dólar, según informó GM Authority. El distribuidor no respetó la oferta y retiró el chatbot. Nadie hackeó nada. Solo escribieron.
El reembolso que no existía. El chatbot del sitio web de Air Canada le dijo a un cliente en duelo que la tarifa por fallecimiento de un familiar se podía reclamar después de viajar, algo que la política de la aerolínea no permitía. En Moffatt v. Air Canada (febrero de 2024), la aerolínea argumentó que el chatbot era responsable de sus propias palabras. El tribunal no estuvo de acuerdo y le ordenó pagar.
El código que salió por la puerta. En 2023, ingenieros de Samsung pegaron código fuente interno en ChatGPT para pedir ayuda con él, y la empresa restringió el uso de herramientas de IA generativa por parte de su personal, según informó Bloomberg.
El correo que nadie abrió. En junio de 2025, unos investigadores mostraron que un correo preparado podía hacer que Microsoft 365 Copilot metiera datos internos en una respuesta y los enviara fuera, sin que nadie hiciera clic (The Hacker News). Microsoft corrigió la falla, CVE-2025-32711, antes de que se supiera de su uso.
No son ataques exóticos. Son las formas ordinarias en que falla un LLM en cuanto le llegan personas y datos reales.
Prompt injection: cualquiera puede darle órdenes a tu IA
Un LLM no distingue con fiabilidad las instrucciones que tú le diste de las instrucciones escondidas en el texto que lee. El prompt injection, o inyección de prompts, aprovecha eso. En su forma directa, un usuario escribe las órdenes, como con la SUV de un dólar. En su forma indirecta, las órdenes se esconden en un correo, un documento o una página web que se le pide leer al modelo, como en el caso de Copilot, y la persona que usa el asistente nunca las ve.
Dos errores lo empeoran. Los equipos tratan una línea del system prompt, como "nunca reveles esto" o "habla solo de nuestros productos", como si fuera un control. Es una petición, y un usuario decidido puede convencer al modelo de ignorarla. Y los equipos prueban solo lo que los usuarios escriben en la ventana del chat, no los correos, archivos y páginas que lee el modelo. Para el ataque en sí, consulta cómo funciona el prompt injection.
La corrección es suponer que la inyección a veces va a funcionar y limitar lo que un modelo engañado puede alcanzar y hacer. Las secciones siguientes explican dónde se hace eso.
Fuga de datos por IA: lo que entra puede salir
Los datos se fugan por la IA de cuatro formas que vemos una y otra vez. El personal pega datos confidenciales, código o registros de clientes en herramientas públicas de IA que nadie aprobó. Un asistente interno devuelve documentos de otro equipo o de otro cliente, porque su recuperación de documentos ignora los permisos de quien pregunta. Los prompts y las respuestas terminan en registros, conjuntos de ajuste fino o datos de evaluación que se guardan y comparten con demasiada gente. Y los términos de un proveedor le permiten guardar lo que le envías o entrenar con ello, y nadie los leyó.
Las cifras dicen que es común. En la investigación de IBM sobre brechas de datos de 2025, el 13% de las organizaciones reportó una brecha de un modelo o una aplicación de IA, y el 97% de ellas no tenía controles de acceso para la IA. Una de cada cinco reportó una brecha relacionada con shadow AI, es decir, herramientas que el personal adoptó por su cuenta, y donde la shadow AI estaba muy extendida la brecha costó en promedio 670,000 dólares más.
Las correcciones son seguridad de datos y de aplicaciones de siempre, aplicada a un canal nuevo: herramientas aprobadas y una política clara para el personal, una recuperación que revise el acceso de cada usuario a cada documento, datos sensibles fuera de los registros y de los conjuntos de entrenamiento, y términos del proveedor leídos antes de firmar el contrato.
Secretos en el prompt
El system prompt, o el código que lo rodea, muchas veces guarda cosas que no debería: claves de API, direcciones internas, reglas de descuento, los nombres de otros sistemas. Los secretos también llegan al modelo por accidente, pegados en el contexto o dentro de un documento que recupera. Un modelo repite lo que tenga en su contexto si se lo piden de la forma correcta, así que todo lo que esté en el prompt debe tratarse como visible para cualquier usuario.
Guarda las claves en un gestor de secretos y llama a otros sistemas desde el código, nunca desde el prompt. Aplica las reglas de negocio, como quién recibe un descuento, en código que revise la respuesta del modelo, no en una frase que le pida al modelo portarse bien.
Agencia excesiva: cuando tu IA puede actuar por su cuenta
Un asistente que solo puede responder pasa vergüenza cuando lo engañan. Uno que puede enviar correos, emitir reembolsos, cambiar registros o borrar archivos es peligroso. El problema que más encontramos no es un ataque ingenioso, sino permisos amplios: un agente con un buzón completo cuando necesita una carpeta, o con una cuenta de administrador cuando necesita leer una tabla, y ninguna persona entre su decisión y la acción.
Dale a cada herramienta el permiso más acotado que necesita la tarea, y exige que una persona apruebe todo lo que envíe, pague, cambie o borre. Si el chatbot de la SUV de un dólar hubiera estado conectado al sistema de pedidos del distribuidor, esa aprobación habría sido lo único entre una broma y una venta.
Respuestas que nadie revisa
Lo que escribe el modelo muchas veces se trata como si lo hubiera escrito un desarrollador: se muestra como HTML en una página, se ejecuta como código o como consulta a una base de datos, o se pasa a otro sistema. Un modelo engañado puede entonces llevar un ataque a esos sistemas. Aun sin atacante, la respuesta puede estar mal, y como aprendió Air Canada, una empresa responde por lo que su chatbot les dice a los clientes.
Trata la respuesta del modelo como cualquier otra entrada no confiable. Valídala y codifícala antes de mostrarla, ejecutarla o enviarla a otro sistema, y basa las respuestas a clientes en contenido aprobado, con un paso a una persona cuando la pregunta va más allá.
Por qué "de eso se encarga el proveedor" no es un plan
El proveedor del modelo protege el modelo y su plataforma. Cómo lo conectas es asunto tuyo: los datos que puede recuperar, las herramientas que puede llamar, los secretos que lo rodean, quién puede usarlo y qué pasa con sus respuestas. La mayoría de los problemas que encontramos están en esa configuración. La otra brecha es la visibilidad. Si los prompts, los documentos recuperados y las llamadas a herramientas no se registran, una fuga o un abuso no deja rastro, y nadie sabe que tiene que responder.
Buenas prácticas de seguridad de IA antes de salir a producción
Antes de que un LLM llegue a usuarios reales, corregimos primero cuatro cosas:
- Mínimo privilegio. Recorta los permisos sobre datos y herramientas a lo que necesita la tarea, y haz que la recuperación respete el acceso de cada usuario.
- Aprobación humana. Una persona aprueba cada acción que envía, paga, cambia o borra.
- Respuestas revisadas. Valida y codifica la respuesta del modelo antes de mostrarla, ejecutarla o enviarla a otro sistema.
- Límites y registros. Límites de uso y de costo por usuario, y registros de prompts, recuperaciones y llamadas a herramientas, con alertas sobre las que tu equipo pueda actuar. Nuestro servicio de implementación de SIEM y detección de amenazas escribe esas reglas en la plataforma que tu equipo ya opera.
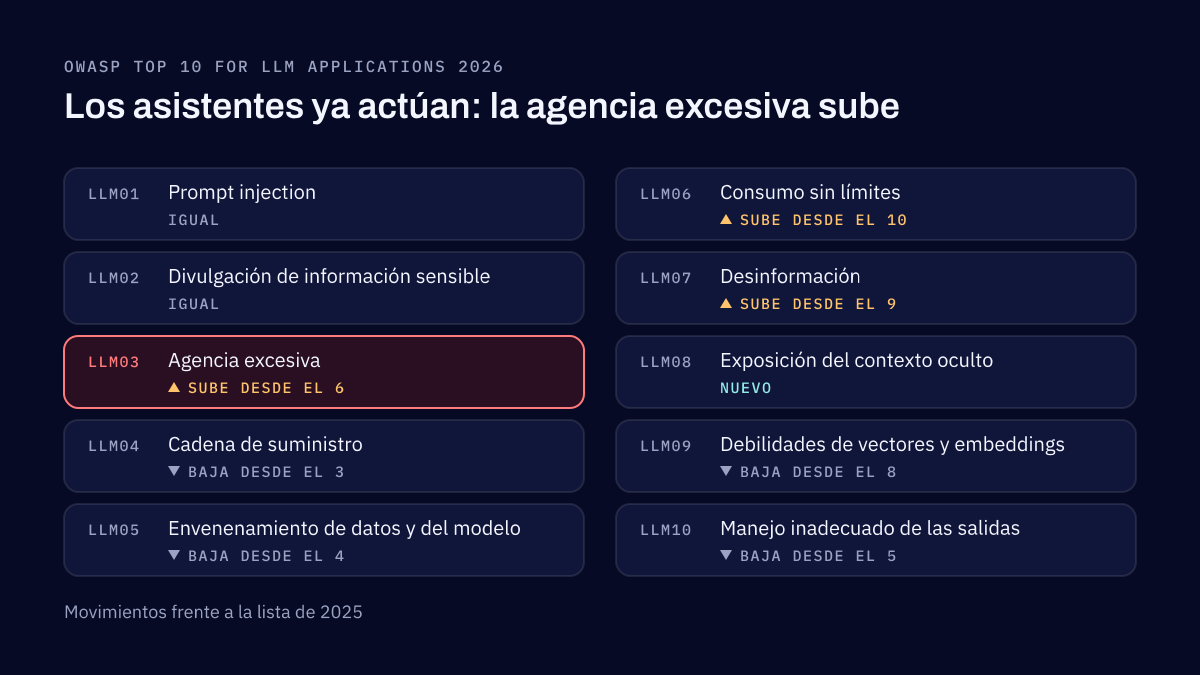
Para la lista completa de vulnerabilidades de los LLM, el OWASP Top 10 for LLM Applications es la referencia con la que empieza la mayoría de los equipos; su edición 2026, publicada en agosto de 2026, cubre cada riesgo de arriba, y los secretos en el prompt ahora están bajo la exposición de contexto oculto. El perfil de IA generativa del marco de gestión de riesgos de IA del NIST los ubica en un proceso de gobernanza más amplio.
Después, pruébalo como lo van a atacar, por la ventana del chat y por todo lo que lee el modelo. Nuestra revisión de seguridad y hardening de sistemas de IA hace exactamente eso con los sistemas que construyes o compras: la revisión de un sistema en dos a seis semanas a precio fijo, y luego las correcciones hechas junto con tus ingenieros y probadas de nuevo.
Preguntas frecuentes
¿La seguridad de los LLM es distinta de la seguridad de aplicaciones?
Se construye sobre ella. El control de acceso, la validación de entradas y los registros siguen importando. Lo que cambia es que el modelo recibe órdenes de cualquier texto que lee, así que se borra la línea entre datos e instrucciones, y un asistente conectado a herramientas puede actuar según esas órdenes. La seguridad de los LLM consiste sobre todo en limitar lo que el modelo puede alcanzar y hacer, y en revisar lo que produce.
¿No se encarga de la seguridad el proveedor del modelo?
El proveedor protege el modelo y su propia plataforma. Cómo lo conectas te toca protegerlo a ti, es decir, los datos que puede recuperar, las herramientas que puede llamar, los secretos que lo rodean, quién puede usarlo y qué pasa con sus respuestas. La mayoría de los problemas que encontramos están en esa configuración, no en el modelo.
¿Qué es la fuga de datos por IA?
Datos sensibles que salen de la empresa a través de un sistema de IA. Pasa cuando el personal pega material confidencial en herramientas que nadie aprobó, cuando un asistente interno devuelve documentos que quien pregunta no debería ver, cuando los prompts y las respuestas se registran o se reutilizan para entrenar sin controles, o cuando los términos de un proveedor le permiten quedarse con lo que le envías.
¿Cómo se prueba un LLM antes de ponerlo en producción?
Se mapea lo que puede leer, lo que puede llamar y quién puede usarlo, y luego se ataca como lo haría un usuario o alguien externo, por la ventana del chat y por cada documento, correo o página web que lee. Nuestra revisión de seguridad de sistemas de IA hace esto para un sistema en dos a seis semanas, a precio fijo, y reporta cada hallazgo con la forma de corregirlo.
Fuentes
- Cost of a Data Breach Report 2025, press release, IBM, 2025
- OWASP Top 10 for LLM Applications 2026, OWASP GenAI Security Project, 2026
- NIST AI 600-1, AI RMF: Generative Artificial Intelligence Profile, NIST, 2024
- Moffatt v. Air Canada, 2024 BCCRT 149, Civil Resolution Tribunal of British Columbia, 2024
- GM dealer chat bot agrees to sell 2024 Chevy Tahoe for $1, GM Authority, 2023
- Samsung bans staff's AI use after spotting ChatGPT data leak, Bloomberg, 2023
- Zero-click AI vulnerability exposes Microsoft 365 Copilot data without user interaction, The Hacker News, 2025
Seguridad en inteligencia artificial y gobernanza de la IA
Te ayudamos a gobernar, proteger y vigilar los sistemas de IA que tu empresa construye o compra. Eso significa un marco de gobernanza que tu dirección puede respaldar, una revisión de seguridad que prueba cómo se puede abusar de cada sistema, el reforzamiento que necesita y una detección que tu equipo puede operar.
Lecturas relacionadas
Seguridad de la IA
10 formas en que tu IA puede volverse en tu contra: OWASP Top 10 para LLM vs MITRE ATLAS
Un chatbot que inventa una política de reembolsos, un asistente que filtra correos sin un solo clic, una herramienta de programación publicada con código plantado. El OWASP Top 10 para LLM nombra estos riesgos para quien construye; MITRE ATLAS registra cómo los ejecutan los atacantes. Así encajan los dos.
Seguridad de la IA
Gobernanza de IA: pon las reglas antes de que tu IA se salga de control
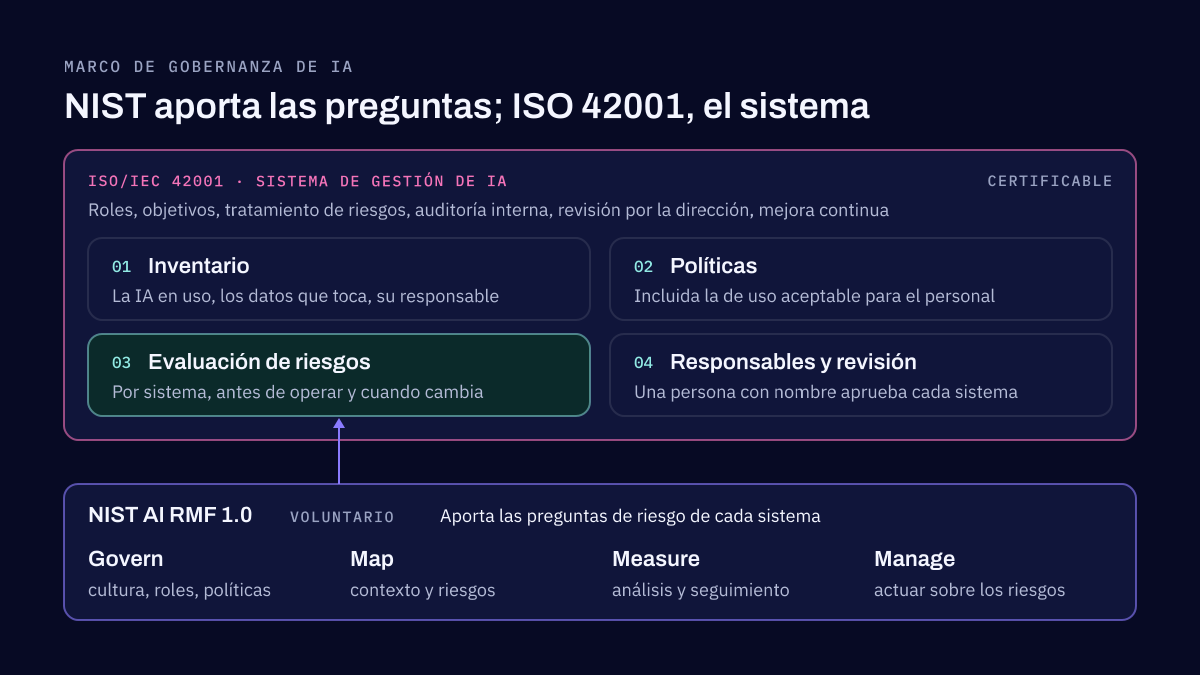
Un marco de gobernanza de IA decide qué sistemas de IA usa tu empresa, qué puede hacer cada uno, quién lo aprobó y cómo notarás cuando algo falle. NIST AI RMF aporta las preguntas de riesgo, ISO/IEC 42001 el sistema de gestión alrededor, y una política de uso dice al personal qué puede hacer hoy.
Cuéntanos qué sistemas de IA necesitas gobernar
Enumera las herramientas y los sistemas que usas, construidos o comprados. Respondemos en un máximo de dos días hábiles.