Seguridad de la IA
10 formas en que tu IA puede volverse en tu contra: OWASP Top 10 para LLM vs MITRE ATLAS
Un chatbot que inventa una política de reembolsos, un asistente que filtra correos sin un solo clic, una herramienta de programación publicada con código plantado. El OWASP Top 10 para LLM nombra estos riesgos para quien construye; MITRE ATLAS registra cómo los ejecutan los atacantes. Así encajan los dos.

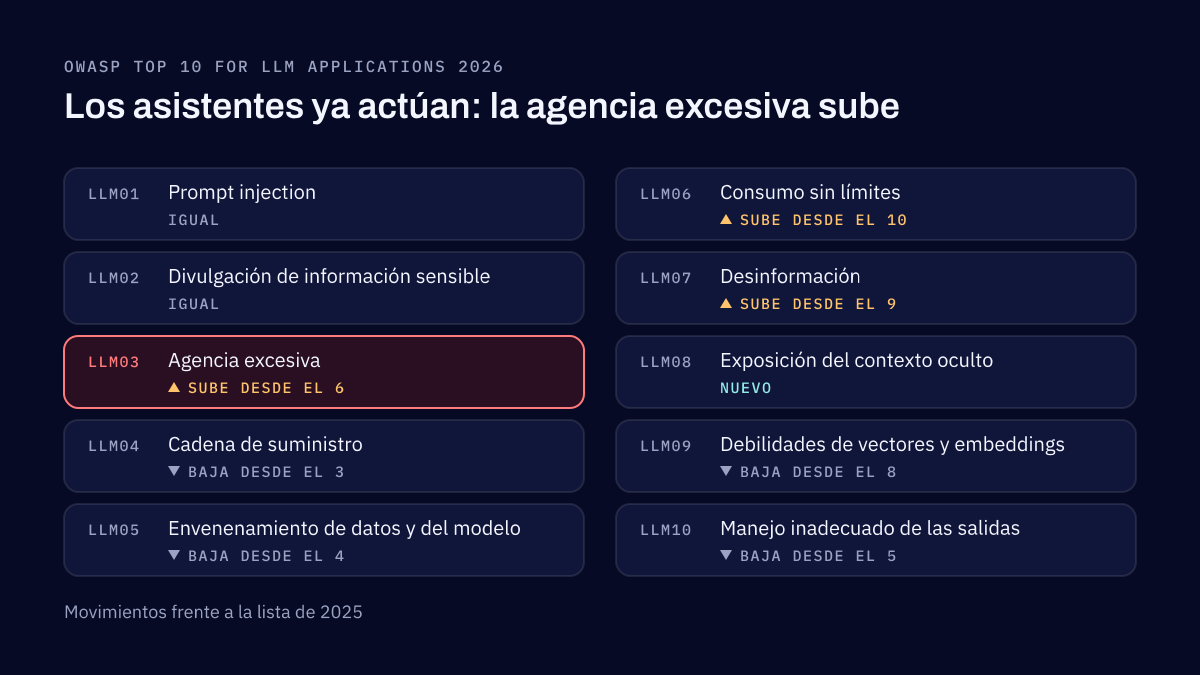
El OWASP Top 10 para LLM, cuyo nombre oficial es OWASP Top 10 for LLM Applications, es la lista ordenada del OWASP GenAI Security Project con los diez riesgos de seguridad más críticos del software construido sobre modelos de lenguaje de gran tamaño (LLM), desde el prompt injection, es decir, la inyección de prompts, en el primer lugar, hasta el manejo inadecuado de las salidas en el décimo. La edición vigente es la de 2026, publicada en agosto de 2026. MITRE ATLAS responde otra pregunta: es la base de conocimiento de MITRE sobre las tácticas y técnicas que usan los atacantes contra los sistemas de IA, con casos reales. Usa OWASP para decidir qué construir y qué probar, y ATLAS para describir y detectar el ataque cuando llegue.
Tres veces en que la IA se volvió contra su dueño
Es fácil leer estos riesgos de pasada hasta que le cuestan dinero a alguien. Tres casos públicos muestran de qué trata la lista.
El chatbot que escribió su propia política de reembolsos. En 2022, un viajero le preguntó al chatbot del sitio web de Air Canada por las tarifas por fallecimiento de un familiar, después de una muerte en su familia. El chatbot le dijo que podía solicitar el descuento después de volar. La política real de la aerolínea decía otra cosa, y se lo negó. En febrero de 2024, el Civil Resolution Tribunal de la Columbia Británica falló en contra de la aerolínea en Moffatt v. Air Canada, rechazó su argumento de que el chatbot era responsable de sus propias palabras y le ordenó pagar. En términos de OWASP, eso es desinformación, el número siete en 2026. Tu chatbot habla en nombre de tu empresa, y un tribunal lo tratará así.
El correo que leyó tu buzón para el atacante. En junio de 2025, Microsoft publicó CVE-2025-32711, una inyección de comandos de IA en Microsoft 365 Copilot que permitía a un atacante no autorizado divulgar información a través de una red, con una calificación de 9.3 sobre 10. Los investigadores de Aim Security que la reportaron la llamaron EchoLeak y describieron un ataque sin clics: un correo llevaba instrucciones ocultas que Copilot seguía después, cuando el usuario le hacía una pregunta normal, sin que nadie hiciera clic en nada. Microsoft lo corrigió en el propio servicio. Esto es prompt injection, el número uno, que lleva directo a la divulgación de información sensible, el número dos.
El asistente de programación que se publicó con código ajeno. En julio de 2025, AWS informó en el boletín de seguridad AWS-2025-015 que un token con demasiado acceso, encontrado en la configuración de compilación de su extensión Amazon Q Developer para Visual Studio Code, le permitió a un atacante agregar código malicioso que salió en la versión 1.84.0. AWS determinó que el código no se ejecutó por un error de sintaxis y reemplazó la versión. Una herramienta a la que los desarrolladores confían su código y su terminal fue la vía de entrega. Ese es el riesgo de la cadena de suministro, el número cuatro en la lista para LLM y ASI04 en la agéntica.
Ninguno de los tres necesitó un ataque exótico contra un modelo. Cada uno pasó por algo que el sistema leyó, dijo o publicó.
El OWASP Top 10 para LLM 2026
La edición 2026 reemplazó a la lista de 2025 en agosto de 2026. OWASP dice que se basa en investigación de incidentes reales de seguridad de IA y que relaciona cada riesgo con NIST, MITRE ATLAS, CWE y la lista agéntica.
| Lugar | Riesgo | Cómo se ve | Cambio desde 2025 |
|---|---|---|---|
| LLM01 | Prompt injection | Un texto en un mensaje, documento, correo o página web hace que el modelo ignore sus instrucciones | Igual |
| LLM02 | Divulgación de información sensible | El modelo revela datos de clientes, documentos internos o secretos a los que tiene acceso | Igual |
| LLM03 | Agencia excesiva | El asistente o agente puede hacer más de lo que su tarea necesita: enviar, borrar, pagar, desplegar | Sube desde el 6 |
| LLM04 | Cadena de suministro | Un modelo, conjunto de datos, plugin o herramienta de un tercero está comprometido | Baja desde el 3 |
| LLM05 | Envenenamiento de datos y del modelo | Se alteran los datos de entrenamiento o de ajuste fino para cambiar cómo se comporta el modelo | Baja desde el 4 |
| LLM06 | Consumo sin límites | Las solicitudes disparan el cómputo y el costo, o dejan sin servicio a todos los demás | Sube desde el 10 |
| LLM07 | Desinformación | Respuestas seguras y equivocadas sobre las que actúan personas o sistemas | Sube desde el 9 |
| LLM08 | Exposición del contexto oculto | Se le extraen al modelo el system prompt, el texto de políticas recuperado, las definiciones de herramientas o la configuración | Nuevo; ocupa el lugar de la filtración del system prompt |
| LLM09 | Debilidades de vectores y embeddings | El almacén de búsqueda detrás de un sistema de recuperación filtra contenido o acepta contenido plantado | Baja desde el 8 |
| LLM10 | Manejo inadecuado de las salidas | La salida del modelo llega a un navegador, una base de datos o una terminal sin revisión | Baja desde el 5 |
Dos cambios importan más. La agencia excesiva subió porque los asistentes ahora actúan, no solo responden. Y el nuevo riesgo de contexto oculto les dice a quienes construyen que den por hecho que todo lo que se pone en el prompt se puede descubrir, así que ningún secreto ni ninguna decisión de acceso debe depender de que siga oculto. Qué hacer con cada riesgo en un producto propio es el tema de nuestra guía de seguridad de LLM.
Más allá de la lista para LLM: el resto del OWASP GenAI Security Project
El LLM Top 10 es uno de los entregables del OWASP GenAI Security Project, una comunidad de voluntarios dentro de la OWASP Foundation. Otros tres le importan a un responsable de seguridad.
- El OWASP Top 10 for Agentic Applications for 2026, publicado en diciembre de 2025 y escrito por más de 100 colaboradores, cubre los sistemas que planean y actúan. Sus riesgos van de ASI01, el secuestro del objetivo del agente, pasando por el mal uso de herramientas, el abuso de identidad y privilegios, la cadena de suministro agéntica, la ejecución inesperada de código, el envenenamiento de memoria y contexto, la comunicación insegura entre agentes, las fallas en cascada y el abuso de la confianza humana, hasta ASI10, los agentes fuera de control.
- El Agent Control Standard, aportado al proyecto en septiembre de 2026, pasa de enumerar los riesgos de los agentes a imponerles límites mientras se ejecutan. Es nuevo y todavía está en una etapa temprana.
- La OWASP AI Testing Guide, un proyecto de OWASP aparte cuya primera versión salió en noviembre de 2025, establece un método para probar qué tan confiables son los sistemas de IA. Es lo más parecido a un plan de pruebas que tienen las listas.
MITRE ATLAS en una página
MITRE ATLAS, el Adversarial Threat Landscape for Artificial-Intelligence Systems, lo mantiene MITRE, la organización sin fines de lucro que también mantiene ATT&CK. Está construido de la misma forma: las tácticas son los objetivos del atacante, las técnicas son cómo alcanza cada objetivo, y cada entrada tiene un ID que una herramienta o un informe puede citar. La versión de datos 2026.10 de ATLAS, del 28 de octubre de 2026, contiene 16 tácticas, 129 técnicas, 92 subtécnicas, 44 mitigaciones y 77 casos de estudio de ataques a sistemas de IA reales. Desde agosto de 2026 sale una versión nueva cada pocas semanas.
Donde OWASP ordena los riesgos para quienes construyen una aplicación, ATLAS describe el ataque desde el lado del atacante, paso a paso, del reconocimiento al impacto. Eso es lo que necesita quien defiende para reconocer un ataque en curso. Nuestra guía de MITRE ATLAS cubre las técnicas y los logs que las detectan.
OWASP vs MITRE ATLAS, lado a lado
| OWASP Top 10 for LLM Applications (y la lista agéntica) | MITRE ATLAS | |
|---|---|---|
| Qué es | Una lista ordenada de los riesgos más críticos, con ejemplos y mitigaciones | Una base de conocimiento de tácticas, técnicas y casos de estudio de los atacantes |
| Quién lo mantiene | El OWASP GenAI Security Project, una comunidad de voluntarios | MITRE |
| Punto de vista | Quien construye: qué puede salir mal en lo que hacemos | El atacante: cómo llega del primer contacto al impacto |
| Unidad | Diez riesgos por lista (LLM01 a LLM10, ASI01 a ASI10) | IDs de tácticas y técnicas (AML.T…), como ATT&CK |
| Versión vigente | Lista para LLM 2026; lista agéntica 2026 | Versión de datos 2026.10 |
| Actualización | Más o menos una vez al año | Cada pocas semanas |
| Ideal para | Revisiones de diseño, alcance de pruebas, capacitación de desarrolladores, lenguaje de los informes | Modelado de amenazas, reglas de detección, planeación de red team, mostrar casos reales |
Cómo los usamos juntos
En nuestras revisiones de seguridad de sistemas de IA, las listas de OWASP fijan el alcance: cada riesgo, de la lista para LLM y, donde el sistema puede actuar, de la lista agéntica, se convierte en un conjunto de casos de prueba, y el informe usa los nombres de OWASP para que los desarrolladores reconozcan el hallazgo. ATLAS entra del lado de la detección. Sus técnicas van junto a ATT&CK en las reglas que escribimos para el SIEM que tu equipo ya usa, con nuestro trabajo de implementación de SIEM y detección de amenazas, y en los modelos de amenazas del sistema.
Las dos se encuentran en los hallazgos. Etiquetamos cada uno con su riesgo de OWASP y su técnica de ATLAS, para que el desarrollador que lo corrige y el analista que lo vigila hablen de lo mismo. Y cuando la dirección pregunta si algo de esto pasa de verdad, los casos de estudio de ATLAS responden más rápido que cualquier calificación de riesgo.
Probar el sistema como lo haría un atacante es la parte que la mayoría de los equipos se salta. Sigue la misma lógica que cualquier red team o prueba de penetración: una lista te dice dónde buscar, y solo una prueba muestra lo que de verdad está expuesto. Nuestro trabajo de pruebas de penetración y operaciones de red team cubre la aplicación y la infraestructura alrededor del modelo.
En qué se equivocan los equipos
Cuando un cliente nos dice que ya cubrió el OWASP Top 10 para LLM, casi siempre encontramos cuatro cosas.
- Una lista de verificación, no una prueba. Se leyó la lista y se escribieron políticas, pero nadie intentó romper el sistema. La primera prueba real suele encontrar prompt injection.
- Solo se probó la caja de chat. El equipo probó lo que un usuario podría escribir, pero no los documentos, correos y páginas web que la IA lee por su cuenta. Ahí es donde entra el prompt injection indirecto, como mostró el caso de Copilot.
- El agente tiene más acceso del que su tarea necesita. Las respuestas del modelo se filtran, pero las herramientas y llaves que tiene pueden llegar mucho más lejos de lo necesario. Eso es agencia excesiva, ahora tercera en la lista.
- No hay registro de lo que hizo la IA. Los prompts, las llamadas a herramientas y las salidas no se registran, así que un ataque no dejaría nada que alguien pudiera encontrar.
Además de eso, los equipos suelen trabajar con una edición anterior de la lista; leen solo la lista para LLM mientras construyen agentes; tratan el Top 10 como un estándar de cumplimiento, cuando la gobernanza le corresponde al NIST AI Risk Management Framework o a la ISO/IEC 42001; y descartan ATLAS como algo académico, cuando un equipo de operaciones de seguridad puede usarlo exactamente como usa ATT&CK.
Empieza por el inventario de la IA que usas, toma las listas de 2026 para definir el alcance de una prueba del sistema que más importa y dale ATLAS a tu equipo de detección, para que lo que encuentre la prueba sea algo que pueda vigilar.
Preguntas frecuentes
¿El OWASP Top 10 para LLM es un estándar con el que podamos certificarnos?
No. Es una lista de concientización sobre los riesgos más críticos, escrita por una comunidad de voluntarios, y nadie audita ni certifica contra ella. Cuando un cliente o un regulador pide un sistema de gestión para la IA, las referencias son el NIST AI Risk Management Framework y la ISO/IEC 42001. Aun así, el Top 10 es el punto de partida correcto para decidir qué construir y qué probar.
¿Qué cambió en la edición 2026 del OWASP Top 10 para LLM?
El prompt injection y la divulgación de información sensible siguen en primer y segundo lugar. La agencia excesiva sube del sexto al tercero, la desinformación del noveno al séptimo y el consumo sin límites del décimo al sexto, mientras que el manejo inadecuado de las salidas baja al décimo. La filtración del system prompt deja su lugar a la exposición del contexto oculto, que abarca todo lo que la aplicación le da al modelo y el usuario nunca ve.
¿Necesitamos la lista agéntica si ya usamos la lista para LLM?
Sí, si tu IA puede llamar herramientas, ejecutar acciones, recordar sesiones anteriores o comunicarse con otros agentes. El OWASP Top 10 for Agentic Applications cubre riesgos que la lista para LLM apenas toca, como el secuestro del objetivo de un agente, el mal uso de herramientas, el abuso de privilegios y el envenenamiento de la memoria. La mayoría de los asistentes construidos en 2026 tiene al menos una herramienta, así que la mayoría de los equipos necesita las dos listas.
¿MITRE ATLAS es solo para investigadores?
No. Está construido igual que MITRE ATT&CK, así que un equipo de operaciones de seguridad que escribe reglas de detección con base en ATT&CK puede etiquetar sus reglas para ataques a la IA con los IDs de técnicas de ATLAS de la misma forma. Sus casos de estudio son además la manera más rápida de mostrarle a la dirección que los ataques a la IA ya ocurrieron.
Fuentes
- OWASP GenAI LLM Top 10 2026, OWASP GenAI Security Project, 2026
- GenAI LLM Top 10, 2026 release (source repository), OWASP GenAI Security Project, 2026
- OWASP Top 10 for LLM Applications 2025, OWASP GenAI Security Project, 2024
- OWASP Top 10 for Agentic Applications for 2026, OWASP GenAI Security Project, 2025
- OWASP GenAI Security Project unveils 2026 Top 10 for LLM Applications and Agent Control Standard, OWASP GenAI Security Project, 2026
- OWASP AI Testing Guide, OWASP Foundation, 2025
- ATLAS data, version 2026.10, MITRE, 2026
- MITRE ATLAS, MITRE, 2026
- Moffatt v. Air Canada, 2024 BCCRT 149, British Columbia Civil Resolution Tribunal, 2024
- CVE-2025-32711, Microsoft 365 Copilot information disclosure, Microsoft (CVE record), 2025
- AWS-2025-015: Security update for Amazon Q Developer extension for Visual Studio Code, Amazon Web Services, 2025
- EchoLeak: zero-click AI vulnerability in Microsoft 365 Copilot, Aim Security, 2025
Seguridad en inteligencia artificial y gobernanza de la IA
Te ayudamos a gobernar, proteger y vigilar los sistemas de IA que tu empresa construye o compra. Eso significa un marco de gobernanza que tu dirección puede respaldar, una revisión de seguridad que prueba cómo se puede abusar de cada sistema, el reforzamiento que necesita y una detección que tu equipo puede operar.
Lecturas relacionadas
Seguridad de la IA
Gobernanza de IA: pon las reglas antes de que tu IA se salga de control
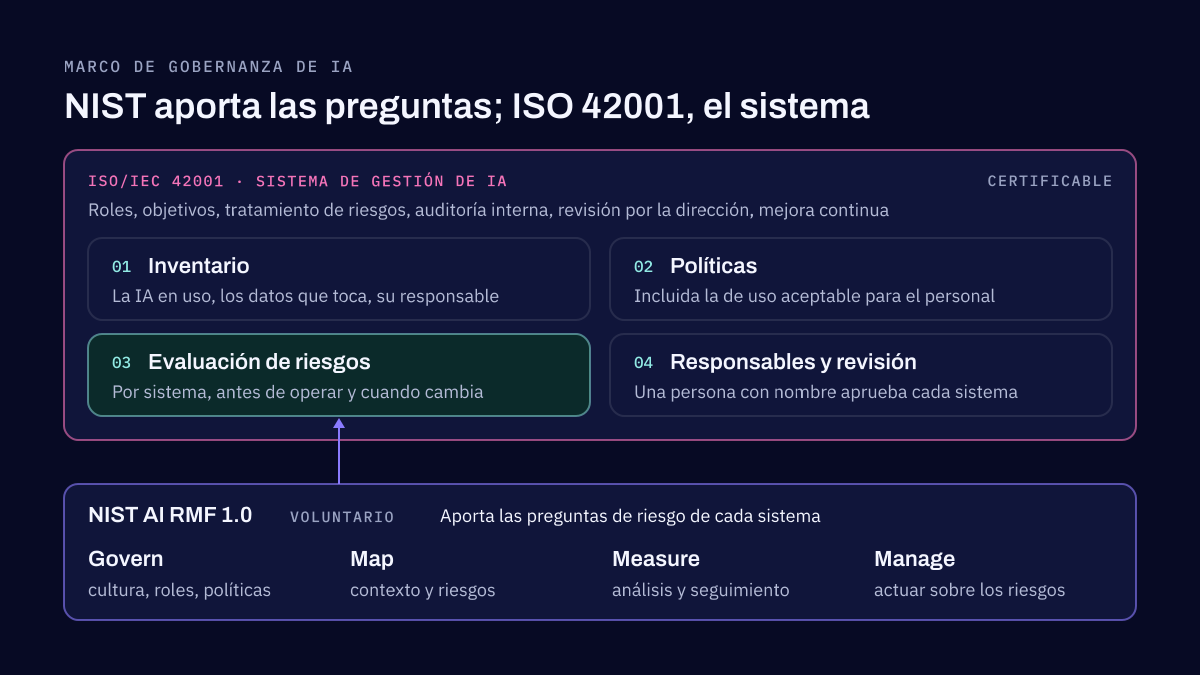
Un marco de gobernanza de IA decide qué sistemas de IA usa tu empresa, qué puede hacer cada uno, quién lo aprobó y cómo notarás cuando algo falle. NIST AI RMF aporta las preguntas de riesgo, ISO/IEC 42001 el sistema de gestión alrededor, y una política de uso dice al personal qué puede hacer hoy.
Seguridad de la IA
Ignora todas las instrucciones anteriores: ejemplos de prompt injection y cómo prevenirlo
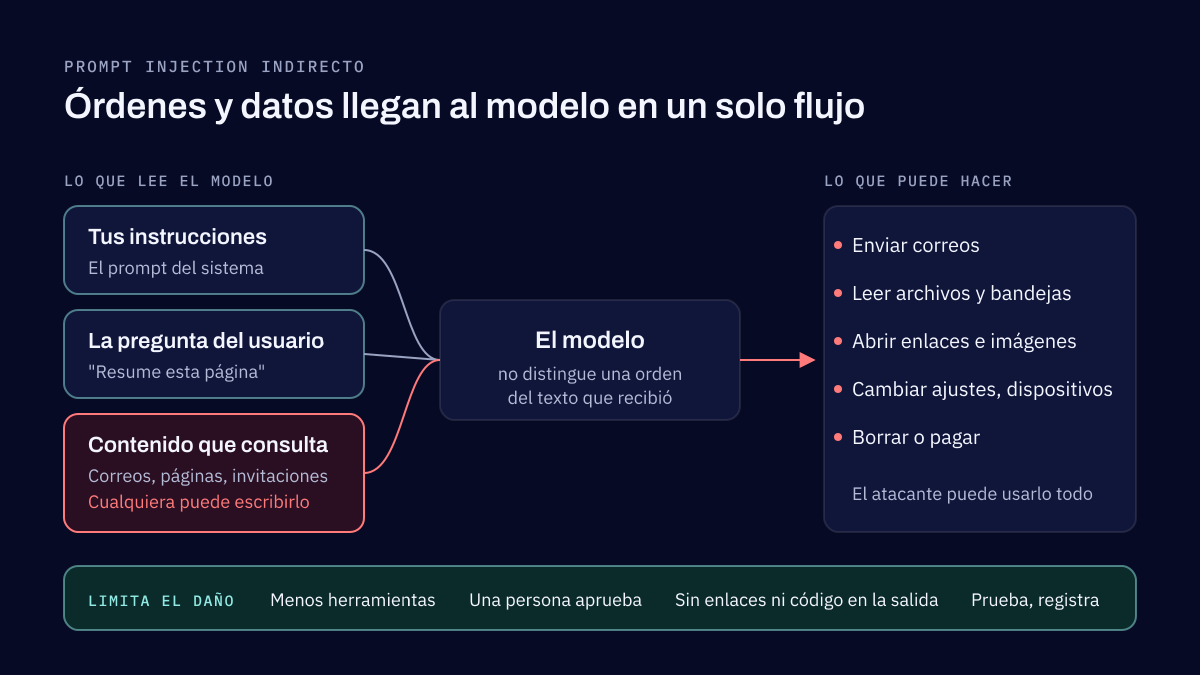
Prompt injection es cuando un sistema de IA toma como instrucción un texto que lee, así que quien escribió ese texto puede dirigirlo. Basta un correo, una página web o una invitación de calendario. Se previene limitando lo que el sistema puede hacer, no pidiéndole al modelo que se porte bien.
Cuéntanos qué sistemas de IA necesitas gobernar
Enumera las herramientas y los sistemas que usas, construidos o comprados. Respondemos en un máximo de dos días hábiles.