Seguridad de la IA
Red teaming de IA: rompe tu IA antes de que lo hagan los atacantes
El red teaming de IA es probar un sistema de IA como lo haría un atacante, para que ignore sus instrucciones, revele lo que no debe o use mal sus herramientas. Se distingue de una prueba de penetración porque el ataque se escribe en lenguaje común, y termina con correcciones que puedes volver a probar.

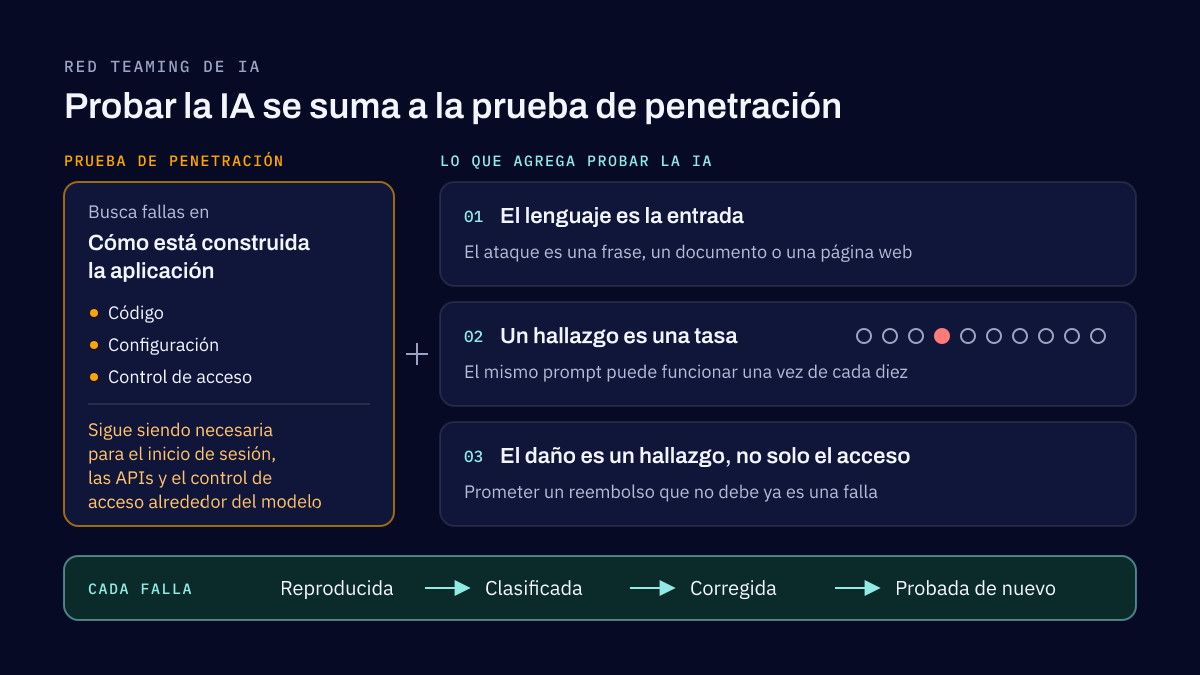
El red teaming de IA es probar un sistema de inteligencia artificial como lo haría un atacante: intentar que ignore sus instrucciones, que revele datos que no debe o que use sus herramientas de formas que nadie previó. Se distingue de una prueba de penetración porque el ataque se escribe en lenguaje común, así que el punto débil suele estar en lo que se le dice al sistema y en cómo se comporta, no solo en cómo está construido. Una buena prueba termina con cada falla reproducida, clasificada y corregida, y luego probada de nuevo.
Cuando los sistemas de IA hacen lo que se les pide, pero quien lo pide es la persona equivocada
Estos son casos reales, cada uno tomado de la empresa, el tribunal o el aviso que lo registró.
- La promesa de un chatbot se volvió la de la empresa. En febrero de 2024, un tribunal canadiense declaró a Air Canada responsable de lo que el chatbot de su sitio web le dijo a un cliente sobre las tarifas por duelo, y le ordenó compensarlo. Lo que una IA le dice a un cliente puede obligar al negocio.
- El mensaje de un colega se volvió un ataque. En agosto de 2024, Slack corrigió un problema en Slack AI que, según la propia empresa, permitía que alguien malintencionado con una cuenta en el mismo espacio de trabajo hiciera phishing a los usuarios para obtener ciertos datos. Slack no encontró evidencia de acceso no autorizado.
- Un correo que nadie abrió podía filtrar datos. En junio de 2025, Microsoft publicó CVE-2025-32711, una inyección de comandos de IA en Microsoft 365 Copilot que permitía a un atacante no autorizado divulgar información, con una calificación de 9.3, crítica. Los investigadores que la encontraron, Aim Labs, la llamaron EchoLeak y la describieron como de cero clics. Microsoft la corrigió de su lado; los usuarios no tuvieron que hacer nada.
Ninguno de estos casos necesitó un firewall roto. Cada uno empezó con palabras que la IA leyó y creyó. El Cost of a Data Breach Report 2025 de IBM encontró que el 13% de las 600 organizaciones estudiadas reportó una brecha en un modelo o una aplicación de IA, y que el 97% de ellas no tenía controles de acceso para la IA.
En qué se distingue de una prueba de penetración
Una prueba de penetración busca fallas en cómo está construida una aplicación: su código, su configuración, su control de acceso. Probar un sistema de IA agrega cuatro diferencias.
- El lenguaje es la entrada. El ataque es una frase, un documento o una página web, así que apunta a lo que se le dice al sistema y a cómo se comporta.
- Los resultados no se repiten. El mismo prompt puede funcionar una vez de cada diez. Cada ataque se repite, y un hallazgo es una tasa, no un sí o un no.
- El daño es un hallazgo, no solo el acceso. Una IA que promete un reembolso que no debe, o que da un consejo peligroso, falló aunque no se haya vulnerado nada.
- La aplicación sigue necesitando su propia prueba. El inicio de sesión, las APIs y el control de acceso alrededor del modelo necesitan una prueba de penetración ordinaria, que hace nuestro servicio de pruebas de penetración y operaciones de red team.
Qué probamos primero
Empezamos por las partes que los equipos dejan sin probar con más frecuencia antes de liberar. El OWASP Top 10 for LLM Applications, la lista de OWASP de los diez riesgos principales de las aplicaciones con modelos de lenguaje, en su edición 2025, nombra cada una.
- Prompt injection indirecto (LLM01). Instrucciones ocultas en contenido que la IA lee, como un documento, un correo, una página web o un ticket de soporte, en lugar de las que escribe el usuario. Así funcionó EchoLeak, y nuestros ejemplos de prompt injection, es decir, de inyección de prompts, muestran más.
- Lo que la IA puede hacer con sus herramientas (LLM06, Excessive Agency, o autonomía excesiva). Enviar correos, cambiar registros o llamar APIs, muchas veces con más permisos que la persona que la usa.
- Fuga del system prompt (LLM07). Si se pueden extraer las instrucciones, claves o detalles internos escritos en el system prompt, las instrucciones de base del sistema.
- Los datos de otras personas (LLM02, Sensitive Information Disclosure, o divulgación de información sensible). Si un usuario puede lograr que la IA le muestre los datos de otro usuario, o documentos internos que puede consultar.
Cada prueba se planea contra técnicas conocidas: MITRE ATLAS, el catálogo público de ataques a sistemas de IA, tenía 129 técnicas a octubre de 2026, y la taxonomía de machine learning adversarial del NIST nombra los ataques y sus mitigaciones. La GenAI Red Teaming Guide de OWASP describe cómo se lleva a cabo una prueba así.
Los errores que más vemos
Antes de probar un sistema, los mismos cuatro errores aparecen una y otra vez:
- Secretos en el prompt. Claves de API, direcciones internas o reglas de negocio escritas en el system prompt y tratadas como ocultas. Todo lo que está en un prompt se puede leer de vuelta.
- Demasiado acceso. La IA conectada a datos y herramientas con permisos amplios para que funcione, más de los que tiene cualquiera de sus usuarios.
- Confiar en la respuesta. La respuesta de la IA se usa directamente para actuar, para enviar, publicar o cambiar un registro, sin que la revise código o una persona.
- Sin registros. Los prompts, las llamadas a herramientas y las respuestas no se registran, así que después nadie puede saber si alguien usó mal el sistema.
Qué recibes
Al final de nuestra revisión de seguridad de sistemas de IA, recibes:
- Cada hallazgo, reproducible. Los prompts o el contenido exactos que lo provocaron, con qué frecuencia funcionó, su severidad y cómo corregirlo.
- Correcciones por capa. Permisos más estrictos sobre los modelos y los datos, revisiones de lo que entra y lo que sale, límites a lo que la IA puede hacer por su cuenta y secretos fuera de los prompts.
- Una nueva prueba. Cuando tu equipo aplica las correcciones, las probamos otra vez, para que sepas qué problemas quedaron cerrados.
- Qué vigilar en producción. Los eventos que hay que registrar para notar un ataque al sistema en operación, el punto de partida de las reglas de detección que opera tu equipo de seguridad, que nuestro servicio de implementación de SIEM y detección de amenazas puede construir.
La revisión toma de 2 a 6 semanas, a precio fijo. El reforzamiento, cuando la revisión pide cambios más profundos, toma de 2 a 4 meses, a precio fijo o por tiempo y materiales.
Antes de liberar
Hazle cuatro preguntas a cualquier sistema de IA antes de que lo usen clientes o empleados. ¿Qué puede leer que un desconocido podría escribir? ¿Qué puede hacer sin que una persona lo apruebe? ¿Qué revelaría si se lo preguntan con astucia? ¿Y te enterarías si alguien lo intentara? Si alguna respuesta es "no estamos seguros", pruébalo antes de que lo haga un atacante.
Preguntas frecuentes
¿El red teaming de IA es lo mismo que el pentesting de IA?
Los dos términos se usan para el mismo trabajo, probar un sistema de IA como lo haría un atacante. Algunas herramientas que se venden como "pentesting de IA" significan lo contrario, usar IA para probar sistemas ordinarios. Este artículo, y nuestra revisión, tratan de probar el sistema de IA en sí.
Usamos el modelo de un proveedor. ¿Aun así tenemos que probar?
Sí. El proveedor prueba el modelo. Tú construiste el sistema a su alrededor, con tus instrucciones, tus datos, las herramientas que puede usar y las personas que pueden llegar a él. La mayoría de las fallas de este artículo están en esas decisiones, no en el modelo.
¿Cuánto tarda una revisión de seguridad de un sistema de IA?
Nuestra revisión de un sistema de IA toma de 2 a 6 semanas, a precio fijo. Si pide cambios más profundos, reforzar el sistema con tus ingenieros toma de 2 a 4 meses, a precio fijo o por tiempo y materiales.
¿La ley exige el red teaming de IA?
Para la mayoría de las empresas, todavía no. La Ley de IA de la UE (EU AI Act) exige pruebas adversariales a los proveedores de modelos de IA de propósito general con riesgo sistémico, no a toda empresa que usa IA. Aun así, probar antes de liberar es la única forma de saber cómo se comporta tu propio sistema cuando alguien intenta usarlo mal.
Fuentes
- Moffatt v. Air Canada, 2024 BCCRT 149, British Columbia Civil Resolution Tribunal, 2024
- Slack security update, August 21, 2024, Slack, 2024
- CVE-2025-32711, M365 Copilot Information Disclosure Vulnerability, Microsoft Security Response Center, 2025
- Cost of a Data Breach Report 2025, press release, IBM, 2025
- OWASP Top 10 for LLM Applications 2025, OWASP Foundation, 2025
- GenAI Red Teaming Guide, OWASP Foundation, 2025
- MITRE ATLAS data, version 2026.10, MITRE, 2026
- NIST AI 100-2 E2025, Adversarial Machine Learning: A Taxonomy and Terminology of Attacks and Mitigations, NIST, 2025
Seguridad en inteligencia artificial y gobernanza de la IA
Te ayudamos a gobernar, proteger y vigilar los sistemas de IA que tu empresa construye o compra. Eso significa un marco de gobernanza que tu dirección puede respaldar, una revisión de seguridad que prueba cómo se puede abusar de cada sistema, el reforzamiento que necesita y una detección que tu equipo puede operar.
Lecturas relacionadas
Seguridad de la IA
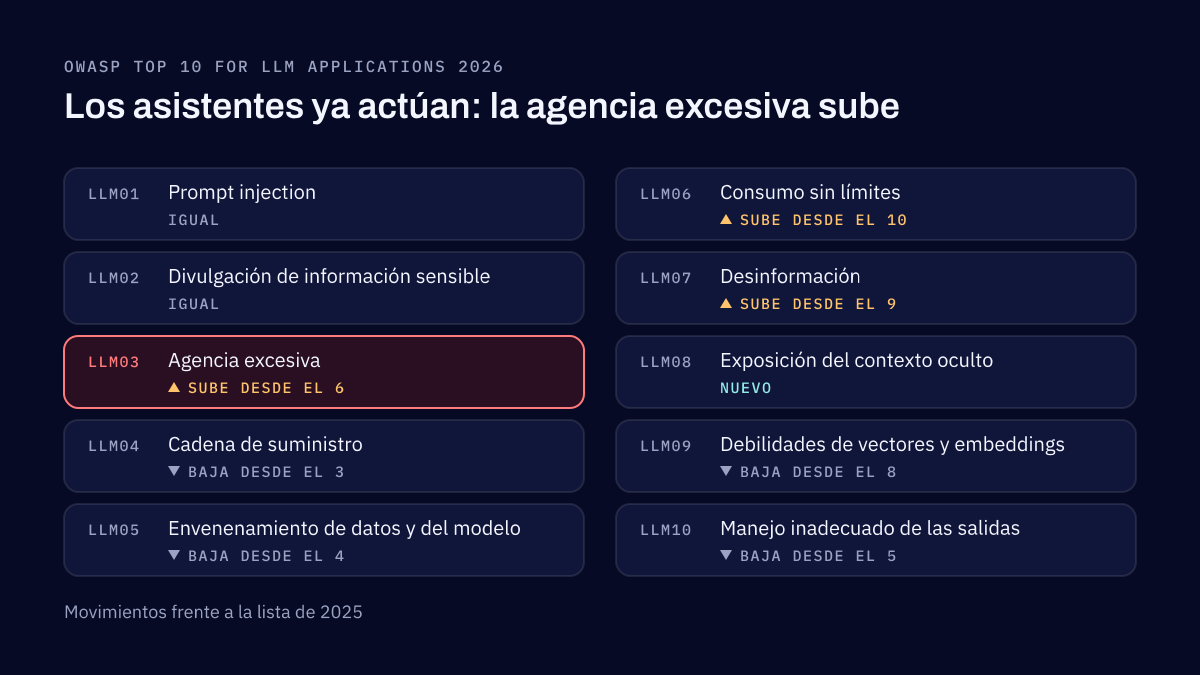
10 formas en que tu IA puede volverse en tu contra: OWASP Top 10 para LLM vs MITRE ATLAS
Un chatbot que inventa una política de reembolsos, un asistente que filtra correos sin un solo clic, una herramienta de programación publicada con código plantado. El OWASP Top 10 para LLM nombra estos riesgos para quien construye; MITRE ATLAS registra cómo los ejecutan los atacantes. Así encajan los dos.
Seguridad de la IA
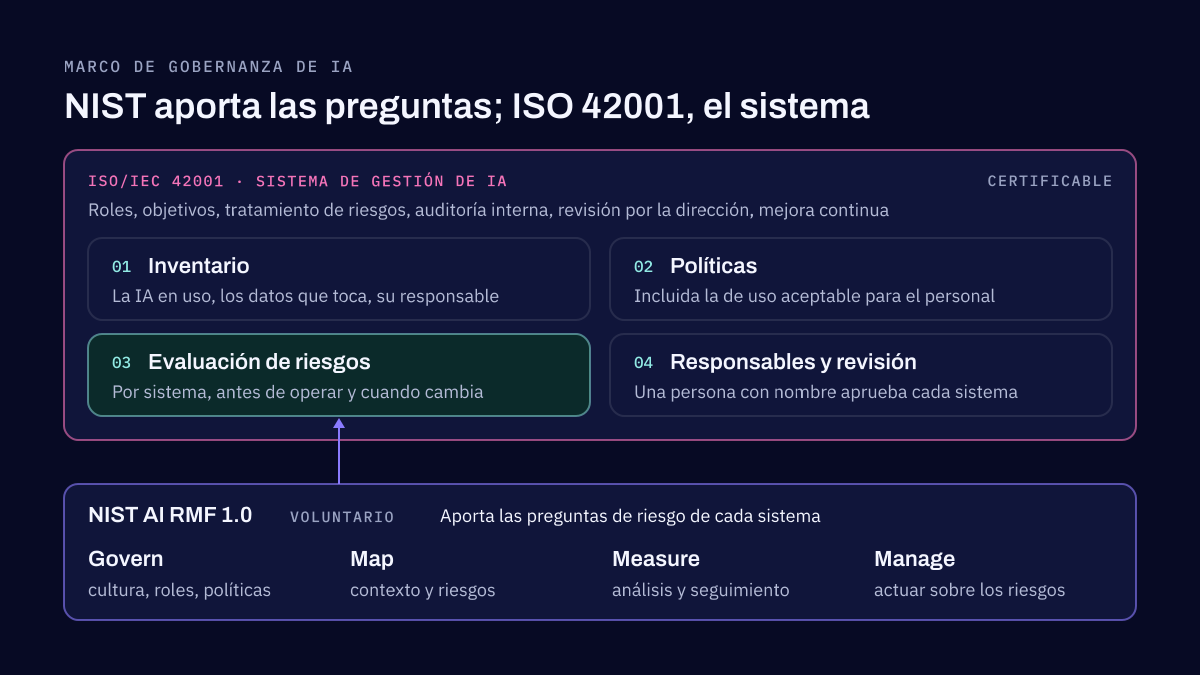
Gobernanza de IA: pon las reglas antes de que tu IA se salga de control
Un marco de gobernanza de IA decide qué sistemas de IA usa tu empresa, qué puede hacer cada uno, quién lo aprobó y cómo notarás cuando algo falle. NIST AI RMF aporta las preguntas de riesgo, ISO/IEC 42001 el sistema de gestión alrededor, y una política de uso dice al personal qué puede hacer hoy.
Cuéntanos qué sistemas de IA necesitas gobernar
Enumera las herramientas y los sistemas que usas, construidos o comprados. Respondemos en un máximo de dos días hábiles.