Continuidad del negocio
Continuidad del negocio y recuperación ante desastres en GCP
La recuperación ante desastres en Google Cloud empieza con dos números, cuánto tiempo puede estar caído un sistema y cuántos datos puede perder, y termina con una prueba que demuestra que puedes cumplirlos. En medio están la elección de zona, región o multirregión, respaldos separados de la carga de trabajo y cada dependencia que la aplicación necesita para funcionar.

La continuidad del negocio en Google Cloud depende de la recuperación ante desastres: decidir cuánto tiempo puede estar caído cada sistema y cuántos datos puede perder, y luego construir y probar una forma de cumplir esos límites. La guía de planeación de recuperación ante desastres de Google llama a esos dos límites objetivo de tiempo de recuperación (RTO) y objetivo de punto de recuperación (RPO). Las decisiones que los cumplen son dónde corre cada carga de trabajo (una zona, una región o varias), dónde viven sus respaldos y si toda la aplicación, no solo sus servidores, vuelve a funcionar cuando la necesitas.
No es poca cosa. En el análisis de interrupciones 2026 del Uptime Institute, el 57% de los operadores encuestados en 2025 dijo que su interrupción grave más reciente costó más de 100,000 dólares, y uno de cada cinco calculó el costo en más de un millón de dólares.
Empieza por el negocio, no por la arquitectura
Los objetivos de recuperación salen de una evaluación del impacto en el negocio: para cada sistema, cuánto tiempo fuera de servicio y cuánta pérdida de datos puede aceptar el negocio, y qué más depende de él. Un sistema de pedidos y una wiki interna no merecen la misma respuesta, y un solo objetivo para todo suele significar que los sistemas importantes quedan poco protegidos y que el resto se paga de más.
Donde veo que las empresas batallan no es en fijar los números, sino en validarlos. Un plan dice cuatro horas; nadie ha medido nunca cuánto tarda una recuperación. Los objetivos solo son tan reales como la última prueba que los cumplió.
A qué sobrevive cada ubicación de Google Cloud
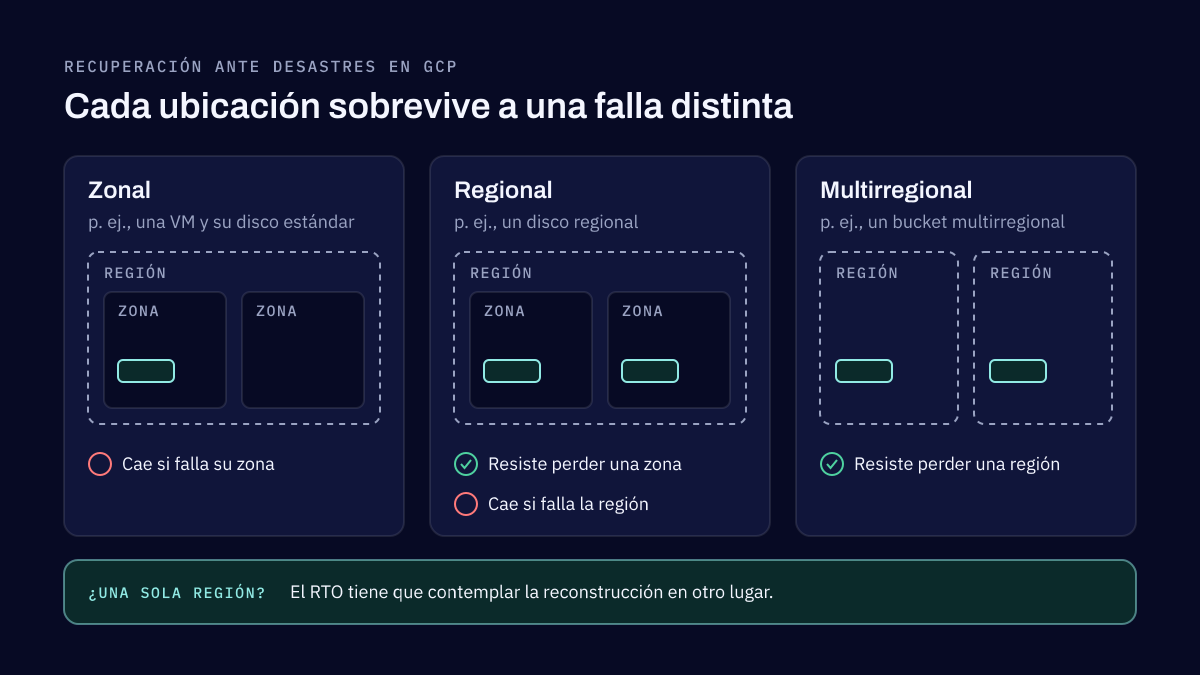
Los recursos de Google Cloud son zonales, regionales o multirregionales, y la guía de arquitectura para la recuperación ante desastres es explícita sobre a qué sobrevive cada uno:
- Los recursos zonales, como una VM de Compute Engine y su disco persistente estándar, pueden verse afectados por una interrupción en esa zona.
- Los recursos regionales se reparten entre zonas y están diseñados para resistir la pérdida de una zona, pero no la de toda la región.
- Los recursos multirregionales, como un bucket de Cloud Storage multirregional, están diseñados para resistir la pérdida de una región.
Operar en una sola región es una decisión razonable para muchos sistemas. Pero es una decisión, y el RTO tiene que contemplar la reconstrucción en otro lugar si esa región no está disponible.
Copias que sobreviven a la falla para la que te preparas
Google describe tres patrones, frío, tibio y caliente, que van desde no tener ningún entorno de respaldo hasta un segundo entorno funcionando y listo. La mayoría de las empresas los combina según el sistema. Las piezas para cada uno:
- Máquinas virtuales y discos. Las instantáneas de disco se guardan de forma predeterminada en la multirregión más cercana al disco de origen. Los discos regionales se replican de forma síncrona entre dos zonas. La Asynchronous Replication copia un disco a una segunda región del mismo continente, con un RPO objetivo de alrededor de un minuto.
- Respaldos separados. Backup and DR Service protege Compute Engine, Persistent Disk, Filestore, Cloud SQL, AlloyDB y varias bases de datos autoadministradas. Sus bóvedas de respaldo pueden imponer una retención mínima durante la cual nadie puede borrar un respaldo, algo que también importa para la protección contra ransomware.
- Bases de datos. La recuperación ante desastres de Cloud SQL se apoya en una réplica de lectura entre regiones que puedes promover. En la edición Enterprise Plus, la recuperación avanzada agrega una réplica de DR designada con switchover y failover de réplica. El failover puede perder datos si la réplica va atrasada; tenlo en cuenta en tu RPO.
- Almacenamiento de objetos. Los buckets birregionales y multirregionales guardan los datos en dos o más lugares. De forma predeterminada, el RPO de los objetos es de hasta 12 horas; la turbo replication lo reduce a 15 minutos en los buckets birregionales. El borrado temporal conserva los objetos borrados 7 días de forma predeterminada, configurable hasta 90.
- Kubernetes. Backup for GKE respalda los recursos de un clúster y sus volúmenes de Persistent Disk, y puede restaurarlos en un clúster de otra región, que debe existir de antemano.
La brecha que encuentro con más frecuencia no es un respaldo que falta. Es un respaldo que nunca se ha restaurado, una segunda región a la que nunca se ha hecho failover, o un entorno de respaldo que comparte el mismo proyecto y los mismos administradores que la carga de trabajo que protege.
Tiene que volver la aplicación, no solo los servidores
La lección a la que más vuelvo es que restaurar la infraestructura no significa que la aplicación esté disponible. Se puede restaurar una base de datos y arrancar las VM, y los clientes siguen viendo un error, porque el DNS apunta a la región anterior, una regla de firewall o una conexión privada nunca se volvió a crear, un secreto vive en otro lado, o un servicio fuera de Google Cloud solo acepta llamadas desde la dirección anterior.
Un plan de recuperación tiene que enumerar esas dependencias y recuperarlas en orden. Las políticas de enrutamiento de Cloud DNS pueden mandar el tráfico a un conjunto de direcciones de respaldo cuando fallan las verificaciones de estado, aunque si todos los endpoints están mal, Cloud DNS los sirve todos como si estuvieran sanos. La red, la identidad y la configuración deberían definirse como código, para que el segundo entorno coincida con el primero y se pueda construir en horas en lugar de redescubrirlo bajo presión. Definir esa base es parte de nuestro trabajo de migración a la nube, y el diseño de la recuperación en sí es una decisión de arquitectura que conviene dejar por escrito antes de necesitarla.
Prueba el plan y luego mídelo
La guía de confiabilidad de Google dice que hay que hacer pruebas periódicas que incluyan failover entre regiones, reversión de versiones y restauración de datos desde respaldos, y comparar los resultados con tu RTO y tu RPO. Yo iría más lejos en tres sentidos:
- Prueba de punta a punta. Haz failover de toda la aplicación y pide a alguien que la use, en lugar de confirmar que cada componente arrancó.
- Automatiza la recuperación. Cada paso manual es un paso que alguien va a hacer mal a las tres de la mañana. Los scripts y la infraestructura como código convierten una recuperación en algo que puedes ejecutar, cronometrar y repetir.
- Mide contra el objetivo. Registra cuánto tardó la recuperación y cuántos datos se perdieron, y compara ambos con los objetivos que fijó el negocio. Si no coinciden, tiene que cambiar la arquitectura o el objetivo.
Una prueba también muestra si los respaldos mismos están bien, si contienen los datos que esperabas y si están protegidos. Una revisión de seguridad en la nube mira la misma pregunta desde el otro lado: quién podría borrar o cambiar esas copias.
Por dónde empezar
Si hoy no tienes un plan probado, empieza en pequeño: elige el sistema que el negocio extrañaría primero, acuerda su RTO y su RPO, restáuralo desde un respaldo en un proyecto separado y cronometra el resultado. Esa sola prueba suele enseñar más que el documento del plan, y muestra dónde invertir después.
Preguntas frecuentes
¿Cuál es la diferencia entre RTO y RPO en Google Cloud?
El objetivo de tiempo de recuperación (RTO) es cuánto tiempo puede estar fuera de línea una aplicación después de un incidente grave. El objetivo de punto de recuperación (RPO) es cuántos datos, medidos en tiempo, puede perder. Google Cloud usa las mismas definiciones en su guía de planeación de recuperación ante desastres. Ambos son primero decisiones de negocio; la arquitectura se deriva de ellos.
¿Google Cloud respalda mis cargas de trabajo automáticamente?
No en el sentido que la mayoría imagina. Google mantiene disponible su propia infraestructura, pero los respaldos de tus máquinas virtuales, bases de datos y clústeres, dónde se guardan, cuánto tiempo se conservan y si se pueden restaurar te toca configurarlos a ti. Backup and DR Service, los respaldos de Cloud SQL y Backup for GKE te dan las herramientas; tú decides cómo se usan.
¿Basta con un despliegue regional para la recuperación ante desastres?
Un recurso regional está hecho para sobrevivir a la pérdida de una zona, no de toda una región. Si el negocio no puede aceptar el tiempo que tomaría reconstruir en otra región, necesitas copias o réplicas en una segunda región, o un servicio multirregional, y una forma probada de cambiar a ellas.
¿Cada cuánto hay que probar un plan de recuperación ante desastres?
Con la frecuencia suficiente para que el resultado siga describiendo el sistema que operas hoy. Una regla útil es probar después de cada cambio importante en la arquitectura y, de punta a punta, al menos una vez al año. La guía de confiabilidad de Google pide pruebas periódicas que incluyan la conmutación por error entre regiones y la restauración de datos desde respaldos.
Fuentes
- Disaster recovery planning guide, Google Cloud, 2024
- Architecting disaster recovery for cloud infrastructure outages, Google Cloud, 2024
- Backup and DR overview, Google Cloud, 2026
- About disaster recovery (DR) in Cloud SQL, Google Cloud, 2026
- About Asynchronous Replication, Google Cloud, 2026
- Data availability and durability, Google Cloud, 2026
- DNS routing policies and health checks, Google Cloud, 2026
- Backup for GKE overview, Google Cloud, 2026
- Perform testing for recovery from failures, Google Cloud, 2026
- Annual outage analysis 2026, Uptime Institute, 2026
Arquitectura de soluciones y diseño de sistemas
Diseñamos cómo debe construirse un sistema antes de que alguien lo construya, o revisamos uno que ya existe. Recibes la arquitectura, las decisiones que la sostienen y una especificación con la que otro equipo puede construir, en dos a seis semanas a precio fijo, o en dos a cuatro meses cuando también se diseña el hardware.
Lecturas relacionadas
Detección de amenazas
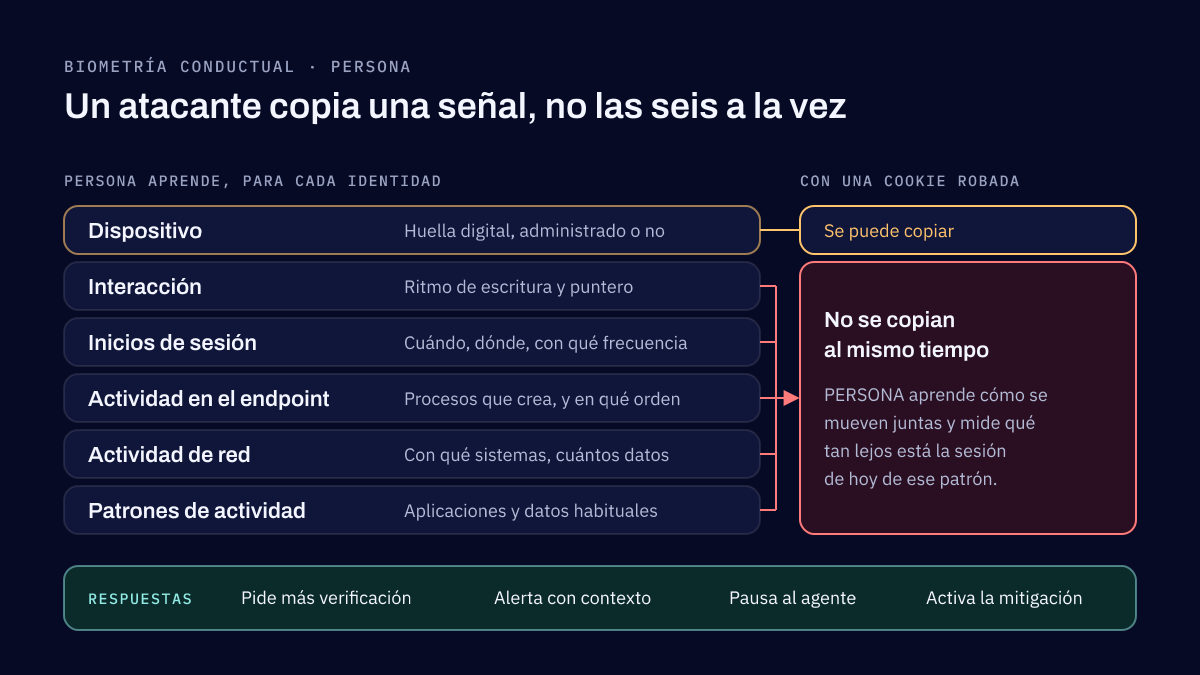
Biometría conductual con ML: PERSONA, vista multimodal de cada usuario, dispositivo y agente de IA
La biometría conductual identifica a un usuario por cómo actúa, no por lo que sabe o trae. Con la huella digital del dispositivo y el contexto de la sesión, y con machine learning, da un perfil que muestra cuándo una cuenta, un dispositivo o un agente de IA deja de actuar como siempre. PERSONA es nuestro nombre para ese perfil.
Detección de amenazas
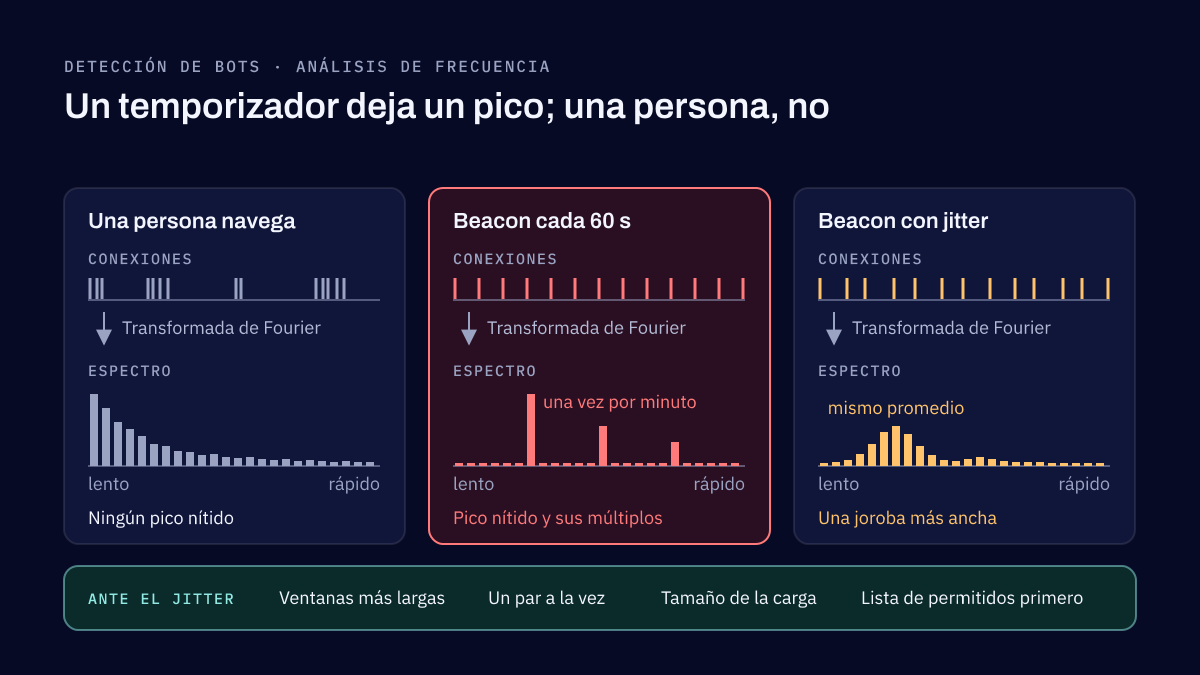
Detectar bots por su ritmo: la transformada de Fourier y el análisis de frecuencia
Casi toda la detección de bots juzga cada solicitud por separado, así que un bot paciente pasa. Los scripts y el malware llevan el tiempo; las personas no. Aquí explicamos cómo una transformada de Fourier convierte ese ritmo en un pico visible, cómo el jitter intenta ocultarlo y dónde encaja el ritmo junto a otras señales.
Cuéntanos qué necesitas diseñar o revisar
Bastan unas líneas sobre el sistema, la decisión que tienes por delante y cualquier fecha límite. Respondemos en dos días hábiles.