Detección de amenazas
Detection as code en la era agéntica: estrategias de CI/CD para equipos de detection engineering
Detection as code es administrar las reglas de detección como los desarrolladores administran el software. Las reglas viven en control de versiones, se escriben en un formato portable como Sigma, se revisan con pull requests, se prueban automáticamente en un pipeline de CI/CD y llegan al SIEM solo a través de ese pipeline.

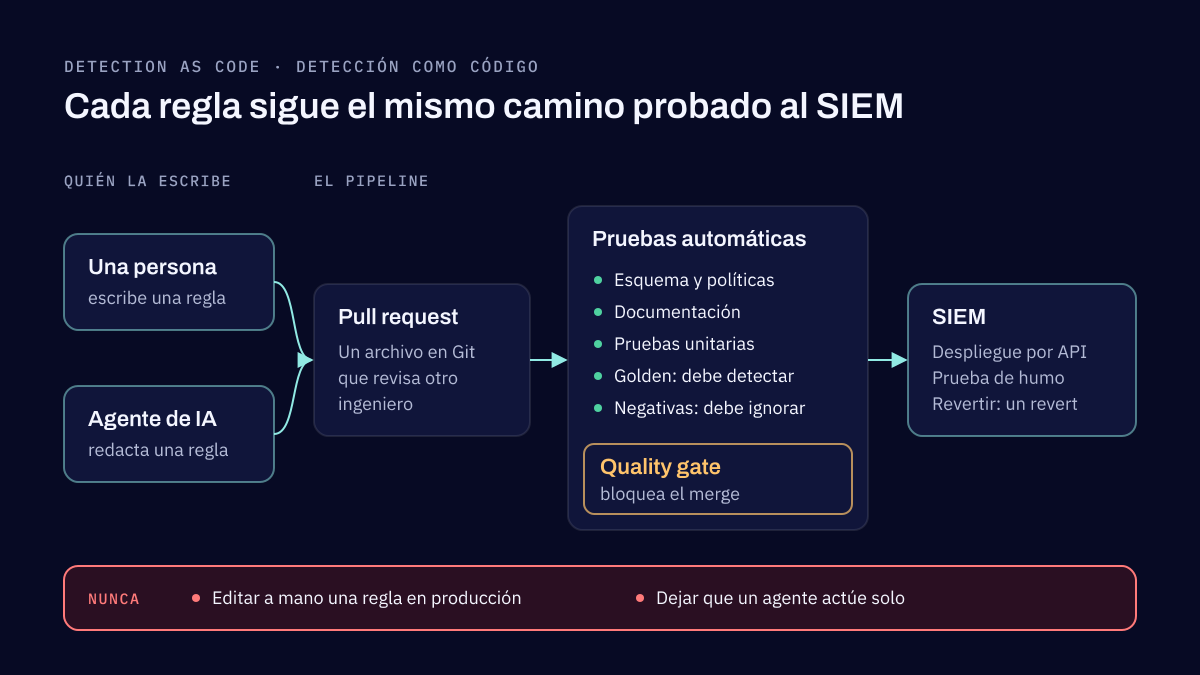
Detection as code, o detección como código, es administrar las reglas de detección como los desarrolladores administran el software. Cada regla vive en control de versiones, escrita en un formato portable como Sigma. Cada cambio pasa por un pull request que alguien revisa. Un pipeline de CI/CD prueba la regla contra eventos que debe detectar y eventos que debe ignorar, y luego la despliega al SIEM. Nadie edita a mano una regla en producción. Los equipos de detection engineering, o ingeniería de detección, lo adoptan porque las reglas administradas así dejan de fallar en silencio. La llegada de los agentes de IA al SOC lo vuelve más urgente, no menos: un agente que escribe reglas necesita las mismas pruebas y el mismo revisor que una persona.
Por qué fallan las reglas de detección cuando viven en la consola
Cuando revisamos un SIEM, aparecen una y otra vez los mismos cinco problemas.
- Reglas editadas en la consola. Alguien cambia una regla a mano para detener una alerta. No hay historial, ni revisión, ni forma de revertirla, y seis meses después nadie sabe por qué la regla quedó como quedó.
- Reglas que fallan en silencio. Una regla nunca se probó, así que cuando una fuente de logs cambia de formato o se renombra un campo, simplemente deja de dispararse. Una regla rota no genera ninguna alerta, así que nada te avisa que está rota.
- Reglas deshabilitadas en lugar de ajustadas. Una regla ruidosa se apaga porque ajustarla toma tiempo. La cobertura se reduce un poco cada vez, y nadie lo nota.
- Cobertura desconocida. Las reglas no están mapeadas a MITRE ATT&CK, así que cuando la dirección pregunta qué técnicas de ataque puedes detectar, nadie sabe responder.
- Documentación dispareja. Algunas reglas tienen descripción, otras tienen runbook, la mayoría no tiene ninguno de los dos. El analista que recibe la alerta no sabe qué significa, qué tan grave es ni quién es responsable de la regla.
El ruido es el síntoma que más sienten los equipos. En la SANS 2025 Detection & Response Survey, el 73% de las organizaciones señaló los falsos positivos como su principal reto de detección, y el 20% los enfrentaba en niveles muy altos, frente al 13% un año antes. Buena parte de ese ruido viene de reglas que nunca se probaron antes de entrar en producción.
Cómo es un pipeline de detection as code
Un primer pipeline no tiene que ser elaborado. Necesita cuatro partes.
Un repositorio, y un pull request para cada cambio. Cada regla es un archivo en Git, con su descripción, severidad, responsable, técnica de ATT&CK y runbook junto a la lógica de detección. Un cambio es un pull request que revisa otro ingeniero. Ahora el historial responde quién cambió qué, cuándo y por qué.
Un formato portable. Sigma es el formato abierto que elige la mayoría de los equipos. Las reglas Sigma son archivos YAML que describen qué buscar y en qué fuente de logs, y los convertidores basados en pySigma las traducen al lenguaje de consulta de Splunk, Elastic, Microsoft Sentinel y otros. La especificación actual de Sigma, la versión 2.1.0, también cubre reglas de correlación. Si solo vas a usar un SIEM, su formato nativo funciona, siempre que esté documentado y el pipeline lo revise.
Pruebas automáticas en cada cambio. El pipeline valida y prueba cada regla antes de que alguien pueda hacer el merge. La siguiente sección enumera las pruebas.
Despliegue mediante la API del SIEM, con posibilidad de revertir. Una vez hecho el merge, el pipeline convierte la regla y la despliega. La versión anterior se queda en el repositorio, así que revertir es un solo revert. Las principales plataformas ya lo permiten. Microsoft Sentinel se conecta a un repositorio de GitHub o Azure DevOps y despliega desde ahí reglas de análisis, consultas de threat hunting y otro contenido, y Microsoft recomienda editar el contenido conectado solo en el repositorio. Elastic publica sus propias reglas desde el repositorio detection-rules, con comandos para validar reglas contra un esquema, correr pruebas unitarias y mover reglas entre el repositorio y Kibana. contentctl, de Splunk, valida, construye y prueba detecciones, y levanta un contenedor de Splunk para correrlas contra eventos reales.
El pipeline en sí es CI/CD común, en GitHub Actions, GitLab CI/CD o Azure DevOps. Si tus desarrolladores ya tienen uno, el equipo de detección puede usar la misma plataforma y las mismas protecciones, que nuestro trabajo en pipelines de CI/CD seguros pone en marcha.
Las pruebas que mantienen honestas las reglas de detección
Detection as code vale lo que vale su aseguramiento de calidad. Estas son las validaciones que pondríamos en un pipeline, más o menos en el orden en que corren.
| Validación | Qué detecta |
|---|---|
| Validación de esquema | Un archivo de regla mal formado, al que le falta un campo obligatorio o que usa un valor que el formato no permite |
| Validación de políticas | Una regla sin responsable, severidad, técnica de ATT&CK o runbook; una regla que rompe tus convenciones de nombres o de severidad |
| Consistencia de la documentación | Una descripción que ya no coincide con la lógica, o un enlace al runbook que no lleva a ningún lado |
| Pruebas unitarias | Errores de lógica en una sola regla, corridas contra eventos de muestra pequeños |
| Pruebas golden | Una regla que ya no se dispara con los eventos de ataque grabados para los que se escribió |
| Pruebas negativas | Una regla que se dispara con actividad normal que debe ignorar, la principal fuente de falsos positivos |
| Quality gates | Un merge que reduce la cobertura, falla una prueba o no tiene revisor; el quality gate lo bloquea |
| Pruebas de humo (smoke tests) | Un despliegue que no llegó, o una regla que no corre, revisado en el SIEM justo después de la liberación |
| Regresión completa | Un cambio en una regla, un parser o una fuente de logs que rompe otras sin que nadie lo note, corrida sobre todo el conjunto de reglas de forma programada y antes de cambios grandes |
Las pruebas golden y las negativas son las dos que la mayoría de los equipos se salta y las que más necesita. Una prueba golden, o de referencia, es un pequeño conjunto de eventos grabados de un ataque real o simulado que la regla siempre debe detectar. Una prueba negativa es un conjunto de eventos normales con los que la regla nunca debe coincidir. Juntas convierten "creemos que la regla funciona" en evidencia que corre en cada cambio.
Mide cada regla después de liberarla
Una regla que pasa sus pruebas todavía puede estar mal en producción. Lleva tres datos de cada regla: cuántas alertas genera, cuántas resultan ser falsos positivos y qué técnicas de ATT&CK cubre. Una regla que se dispara todo el tiempo se ajusta en un pull request, no se apaga en la consola. A una regla que lleva meses sin dispararse se le vuelve a correr su prueba golden, para confirmar que todavía puede hacerlo.
Guarda también el mapeo a ATT&CK en el repositorio, porque ATT&CK cambia. La versión 19, publicada en abril de 2026, dividió la táctica Defense Evasion en dos tácticas nuevas, Stealth y Defense Impairment, y la versión 20 llegó en octubre de 2026. Un equipo cuyos mapeos están en archivos puede actualizarlos en un solo cambio revisado y regenerar su mapa de cobertura el mismo día. Un equipo cuyos mapeos están en una hoja de cálculo, o en ningún lado, empieza de cero.
El SOC autónomo: qué pueden hacer los agentes de IA en detection engineering
Los agentes de IA están llegando al SOC. En marzo de 2025, Microsoft anunció los agentes de Security Copilot, entre ellos uno que separa las alertas de phishing en amenazas reales y falsas alarmas y aprende de la retroalimentación de los analistas. En abril de 2025, Google anunció un agente de triaje de alertas para Google Security Operations que reúne evidencia de cada alerta y registra el razonamiento detrás de su veredicto. En la encuesta de SANS, el 76% de las organizaciones planeaba ampliar su uso de IA y machine learning, o aprendizaje automático, en detección y respuesta. "AI SOC", "agentic SOC" y "autonomous SOC" ya son categorías de producto.
Detection as code es lo que lo vuelve seguro. Aquí es donde pondríamos el límite.
- Deja que los agentes hagan el triaje y enriquezcan las alertas. Agrupar alertas relacionadas, agregar contexto del usuario, del activo y de inteligencia de amenazas, y escribir un resumen para el analista ahorra tiempo real y no cambia nada.
- Deja que los agentes investiguen, solo con lectura. Correr búsquedas en logs e inteligencia de amenazas para responder la pregunta de un analista es útil, siempre que el acceso del agente sea de solo lectura.
- Deja que los agentes redacten reglas, como pull requests. Un agente puede proponer una regla nueva después de un incidente, o un ajuste para una regla ruidosa. La propuesta pasa por las mismas validaciones de esquema, pruebas golden y negativas y revisión humana que cualquier otro cambio. Al pipeline no le importa quién escribió la regla.
- Nunca dejes que los agentes actúen solos. Aislar un equipo, deshabilitar una cuenta o subir una regla a producción espera a que una persona lo apruebe. Una persona sigue en el ciclo, y cada acción que el agente propone queda registrada.
Un agente que puede cambiar tus detecciones también es algo que un atacante va a intentar manipular, a través de las alertas, los logs y los documentos que lee. Trátalo como una identidad con los permisos mínimos que necesita, como explica nuestro artículo sobre seguridad de la IA agéntica, y vigila los ataques contra la propia IA, que MITRE ATLAS mapea. Un SOC autónomo sin un pipeline probado detrás es un ingeniero sin revisión con acceso a producción.
Por dónde empezar
No necesitas reconstruir todo de una vez.
- Exporta tus reglas actuales a un repositorio, tal como están, y haz del repositorio el único lugar donde cambian las reglas.
- Agrega validaciones de esquema y de políticas, para que cada regla tenga responsable, severidad, técnica de ATT&CK y runbook.
- Escribe pruebas golden y negativas para las diez reglas que más importan, y luego agrega pruebas a cada regla que toques.
- Conecta el pipeline a la API del SIEM y desactiva la edición manual de las reglas desplegadas.
Si estás implementando un SIEM, o terminando uno que nunca se configuró bien, empezar así cuesta poco. Nuestro servicio de implementación de SIEM y detección de amenazas despliega Microsoft Sentinel, Splunk, Elastic Security o Wazuh, escribe reglas de detección mapeadas a MITRE ATT&CK, prueba cada una contra actividad simulada y entrega la plataforma a tu equipo con runbooks, normalmente en dos a cuatro meses.
Preguntas frecuentes
¿Qué es detection as code?
Es operar las reglas de detección como software. Cada regla es un archivo en un repositorio, escrita en un formato documentado, que solo cambia mediante un pull request revisado, se prueba automáticamente en cada cambio y un pipeline la despliega al SIEM. Nadie edita a mano una regla de producción en la consola.
¿Tenemos que escribir nuestras reglas en Sigma?
No. Sigma es el formato portable más usado, y sus convertidores traducen una regla al lenguaje de consulta de Splunk, Elastic, Microsoft Sentinel y otros, lo que ayuda si cambias de plataforma o usas más de una. Escribir las reglas en el lenguaje propio de tu SIEM también funciona. Lo importante es que el formato esté documentado y que el pipeline lo revise.
¿Los agentes de IA pueden escribir reglas de detección?
Pueden redactarlas, y son útiles para eso. El borrador debe llegar como pull request y pasar por las mismas validaciones de esquema, pruebas y revisión humana que una regla escrita por una persona. Un agente nunca debe subir una regla a producción, aislar un equipo ni deshabilitar una cuenta sin que alguien lo apruebe.
¿GUILDA va a operar nuestro SOC?
No. Implementamos el SIEM, escribimos y probamos las reglas de detección y entregamos la plataforma con runbooks. La opera tu equipo o el proveedor que tú elijas. No ofrecemos un servicio de monitoreo.
Fuentes
- 2025 Detection & Response Survey, SANS Institute, 2025
- Sigma specification, SigmaHQ, 2025
- ATT&CK updates, April 2026 (v19), MITRE, 2026
- Deploy custom content from your repository, Microsoft Sentinel, Microsoft Learn, 2026
- detection-rules, Elastic, 2026
- contentctl, Splunk, 2026
- Microsoft unveils Microsoft Security Copilot agents and new protections for AI, Microsoft, 2025
- Driving secure innovation with AI and Google Unified Security, Google Cloud, 2025
Implementación de SIEM y detección de amenazas en ciberseguridad
Implementamos un SIEM, conectamos las fuentes de logs que importan, escribimos reglas de detección mapeadas a MITRE ATT&CK y entregamos la plataforma con runbooks. Después la opera tu equipo; no ofrecemos un servicio de monitoreo.
Lecturas relacionadas
Detección de amenazas
Biometría conductual con ML: PERSONA, vista multimodal de cada usuario, dispositivo y agente de IA
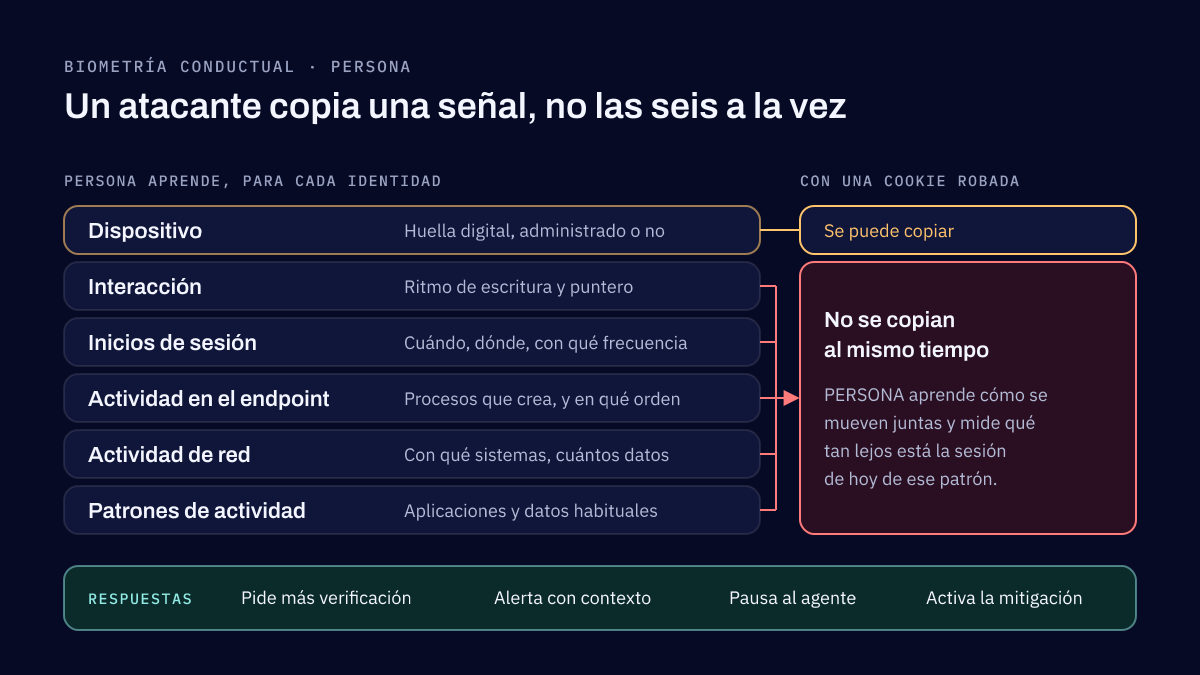
La biometría conductual identifica a un usuario por cómo actúa, no por lo que sabe o trae. Con la huella digital del dispositivo y el contexto de la sesión, y con machine learning, da un perfil que muestra cuándo una cuenta, un dispositivo o un agente de IA deja de actuar como siempre. PERSONA es nuestro nombre para ese perfil.
Detección de amenazas
Detectar bots por su ritmo: la transformada de Fourier y el análisis de frecuencia
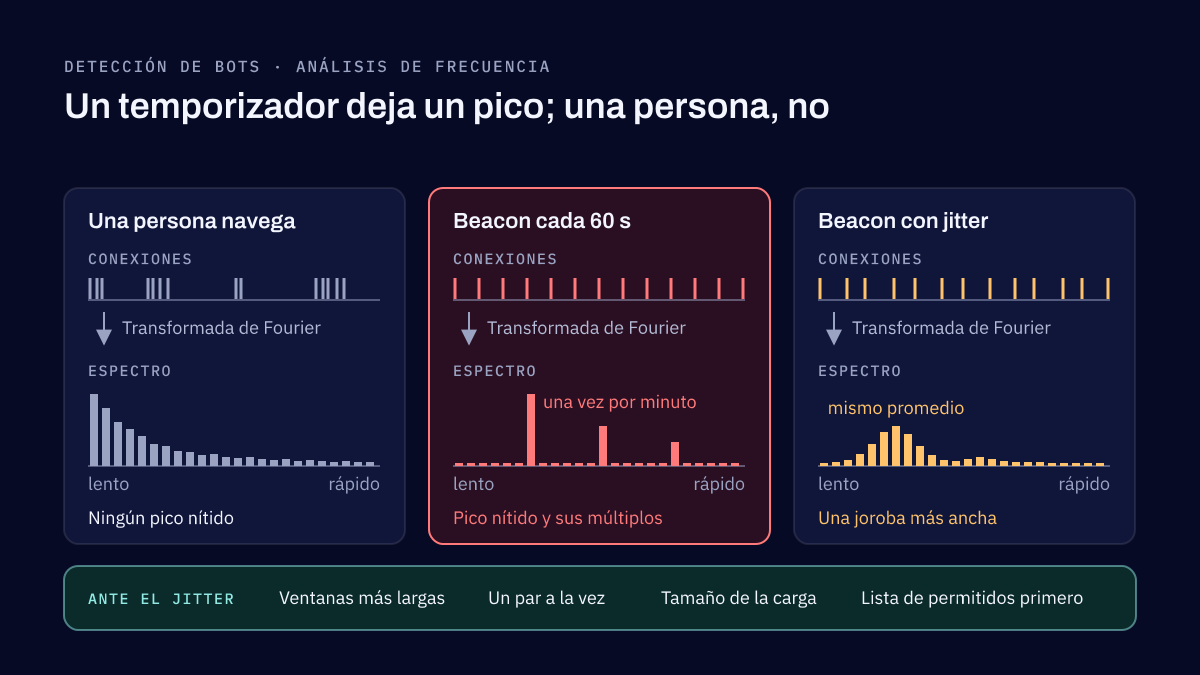
Casi toda la detección de bots juzga cada solicitud por separado, así que un bot paciente pasa. Los scripts y el malware llevan el tiempo; las personas no. Aquí explicamos cómo una transformada de Fourier convierte ese ritmo en un pico visible, cómo el jitter intenta ocultarlo y dónde encaja el ritmo junto a otras señales.
Cuéntanos qué necesitas detectar
Nombra tus sistemas y el requisito detrás del proyecto. Respondemos en un plazo de dos días hábiles.