Detección de amenazas
Machine learning en ciberseguridad: por qué el ML tradicional sigue sosteniendo la detección
El machine learning en ciberseguridad son modelos que aprenden de los datos cómo se ve un ataque o lo normal, y marcan lo que coincide con lo primero o rompe lo segundo. Estos modelos tradicionales califican cada evento en tu EDR, tu seguridad de correo y tu SIEM. Los LLM ayudan después de la alerta, no antes.

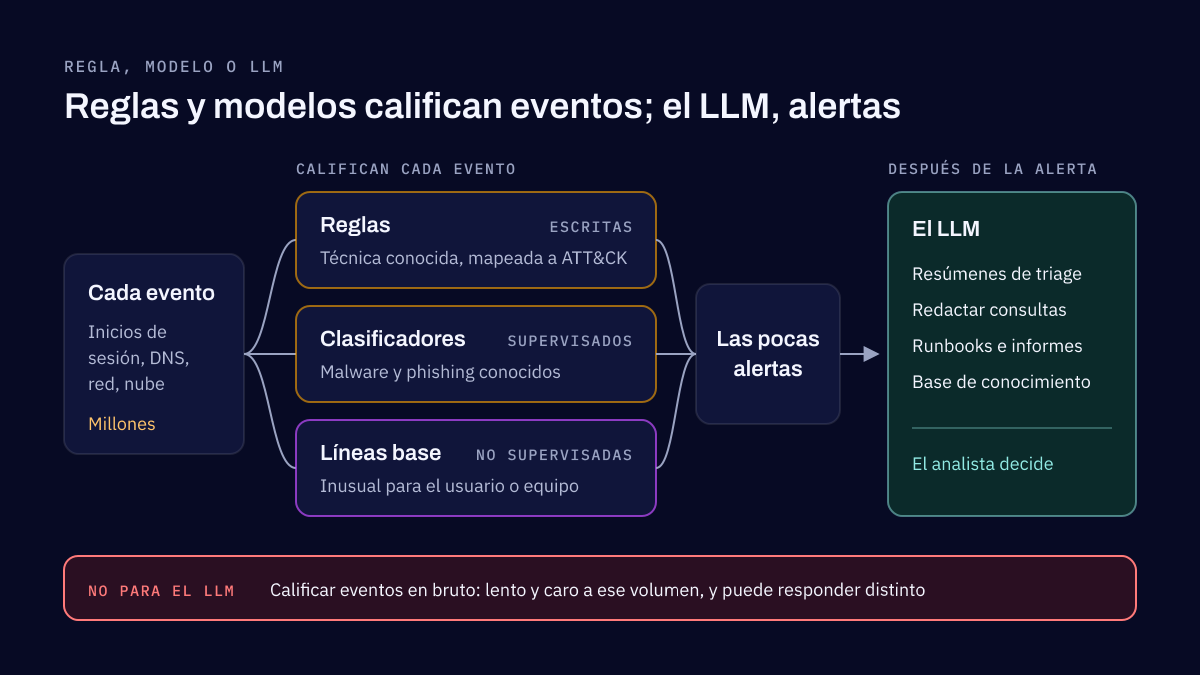
El machine learning en ciberseguridad, o aprendizaje automático, es el uso de modelos que aprenden de los datos cómo se ve un ataque, o cómo se ve la actividad normal, y marcan lo que coincide con lo primero o rompe lo segundo. Los del primer tipo son clasificadores supervisados: los modelos de malware y phishing dentro de tu EDR y tu seguridad de correo. Los del segundo son modelos de detección de anomalías: las líneas base de tu SIEM que notan un inicio de sesión, una descarga o una conexión que no encaja. Califican cada evento, rápido y a bajo costo, y esa es la parte de la detección de amenazas que los LLM no pueden asumir. Los LLM se ganan su lugar después de la alerta, en el triage, las consultas y la base de conocimiento del equipo.
Los dos tipos de machine learning que encuentran ataques
Casi toda la detección de amenazas con machine learning que hoy está en producción pertenece a una de dos familias.
Aprendizaje supervisado: clasificadores que reconocen actividad maliciosa. El modelo se entrena con ejemplos ya etiquetados como buenos o malos, y aprende a distinguirlos. Así decide el EDR que un archivo es malware y así decide la seguridad de correo que un mensaje es phishing. La integración de detección de algoritmos de generación de dominios (DGA) de Elastic es un caso claro: un modelo supervisado califica cada consulta DNS según qué tan probable es que el dominio lo haya generado un malware, y una de sus reglas marca dominios conocidos del ataque SUNBURST contra SolarWinds. Los clasificadores son buenos con lo que ya se les mostró, y nadie en tu equipo tiene que entrenarlos.
Aprendizaje no supervisado: detección de anomalías. Aquí no hay etiquetas. El modelo aprende cómo se ve lo normal para cada usuario, equipo o cuenta, y mide cuánto se aleja de eso la actividad nueva. Microsoft Sentinel construye estas líneas base con el propio historial de una entidad, con el de sus pares y con el de la organización completa, y le da a cada anomalía una calificación entre 0 y 1. La detección de anomalías puede encontrar lo que nadie ha etiquetado todavía, y ese es su valor; no puede distinguir lo inusual de lo malicioso, y ese es su límite.
Dónde el ML tradicional se gana su lugar
En proyectos reales, cuatro tipos de detección justifican el esfuerzo.
- Líneas base de inicio de sesión. Un usuario que inicia sesión desde un país nuevo, a una hora rara o con mucha más frecuencia de lo normal, comparado con su propio historial y con colegas del mismo puesto. Este es el núcleo del análisis del comportamiento de usuarios y entidades (UEBA), y es donde las credenciales robadas aparecen primero.
- Los clasificadores integrados en tus herramientas. Los modelos supervisados del EDR y la seguridad de correo hacen la mayor parte del trabajo diario. Detectan el malware y el phishing para los que nadie escribió una regla, y no te cuesta nada entrenarlos.
- Beaconing y tiempos. El malware que tomó el control de una máquina se comunica con su servidor, a menudo a intervalos regulares; a eso se le llama beaconing. La detección de beaconing de Sentinel mide el tiempo entre conexiones de un mismo origen a un mismo destino y marca los patrones que se repiten. Es detección de anomalías en series de tiempo aplicada a los registros de red, DNS y proxy: una laptop que contacta la misma dirección cada 60 segundos, toda la noche, merece una revisión.
- Volumen y gasto. Líneas base de llamadas a APIs en la nube, descargas, cargas y transferencia de datos para cada cuenta. Una clave que normalmente hace unos cientos de llamadas al día y de pronto hace cuarenta mil, o un usuario que sube diez veces su volumen habitual, es una clave robada o una exfiltración que ninguna regla anticipó.
Qué detecta bien cada método y qué se le escapa
| Método | Detecta bien | Se le escapa |
|---|---|---|
| Clasificadores supervisados | Familias de malware conocidas y sus variantes, phishing parecido al de antes, dominios generados | Ataques distintos a todo lo que hay en los datos de entrenamiento; etiquetas que envejecieron |
| Agrupamiento y grupos de pares | Un usuario que actúa distinto a todos los de su mismo puesto o equipo | Equipos pequeños sin pares reales; trabajos legítimos que ocurren una sola vez |
| Modelos de series de tiempo | Beaconing regular, picos repentinos de volumen o de costo | Robos lentos y de poco volumen; conexiones con jitter, es decir, con variación aleatoria; cierres de mes y otros picos de temporada |
| Líneas base de comportamiento (UEBA) | Toma de control de cuentas, acceso inusual a datos sensibles | Alguien interno que se mantiene dentro de su patrón normal; cualquiera cuyo puesto acaba de cambiar |
Ninguna fila de esa tabla lo cubre todo, y por eso los métodos se combinan con reglas escritas en lugar de elegirse en vez de ellas.
Por qué la detección con ML decepciona
La encuesta SANS 2025 Detection and Response Survey encontró que el 53% de las organizaciones usa machine learning para detectar amenazas, y que el 39% ya lo considera muy útil, contra el 22% un año antes. En la misma encuesta, los falsos positivos fueron el principal problema de detección, citado por el 73% de quienes respondieron, y casi el 17% no sabía si su organización usaba ML en absoluto. La propia Microsoft retiró dos de las reglas de anomalías DGA de Sentinel el 8 de marzo de 2026, por la baja calidad de sus resultados. El machine learning no es la excepción a la regla de que una detección tiene que ganarse su lugar.
Cuando la detección con ML les falla a los clientes, suele ser por una de cinco razones:
- Todo se activó de una vez. Cada regla de anomalías se enciende sin ajustar, la cola se llena de ruido y los analistas aprenden a cerrar anomalías sin leerlas. La documentación de Microsoft reconoce que las anomalías son famosas por su ruido.
- Líneas base aprendidas en el periodo equivocado. Las reglas de anomalías de Sentinel suelen entrenarse de 7 a 21 días. Si esos días incluyen un cierre de mes, una migración o un atacante que ya estaba dentro, el modelo aprende una normalidad equivocada.
- Sin explicación. Si nadie puede decir por qué el modelo marcó un evento, los analistas no confían en él, y una alerta en la que nadie confía no se atiende.
- Esperar que el ML reemplace a las reglas. Una técnica conocida con un patrón claro se detecta con más confiabilidad con una regla escrita y mapeada a MITRE ATT&CK que esperando a que parezca inusual.
- Nunca se vuelve a ajustar. El modelo sale a producción, el negocio cambia a su alrededor y nadie lo recalibra.
Cada cuánto ajustar las detecciones con machine learning
El último error es el más común, y se corrige con un calendario:
- Cada semana durante el primer mes después de que un modelo sale a producción: revisa los falsos positivos y ajusta los umbrales. Después, cada mes.
- Una revisión trimestral de cada detección con ML: qué se disparó, qué resultó cierto y qué hay que ajustar o apagar.
- Después de cualquier cambio que mueva lo normal: una migración, una fusión, una oficina nueva, el paso al trabajo remoto, una nueva aplicación SaaS. Cada uno vuelve obsoleta la línea base anterior.
- Cuando baja la precisión: mide la tasa de verdaderos positivos de cada detección y, cuando caiga por debajo de un nivel acordado de antemano, ajústala o retírala.
Dónde ayudan los LLM y dónde no
Los LLM son buenos con el lenguaje, y un equipo de seguridad produce mucho. Usados después de la alerta, ahorran tiempo real:
- Resúmenes de triage. La alerta, el usuario, el equipo y los eventos relacionados, resumidos para que el analista decida más rápido. El analista sigue decidiendo.
- Redacción de consultas. Redactar o traducir consultas de detección en KQL, SPL o ES|QL, que un ingeniero revisa y prueba antes de usarlas.
- Runbooks e informes. Primeros borradores de runbooks, documentos de entrega e informes de incidentes a partir de las notas del analista.
- La base de conocimiento del equipo. Responder las preguntas de los analistas con base en incidentes anteriores, runbooks y notas de activos; redactar una entrada de la base de conocimiento por cada incidente cerrado, para que la lección quede por escrito; convertir informes de amenazas en notas y en detecciones candidatas que revise un ingeniero.
Lo que no deben hacer es calificar eventos en bruto. Con el volumen de los registros, un LLM es demasiado lento y demasiado caro, y puede dar una respuesta distinta a la misma pregunta en una segunda ejecución. La detección necesita lo contrario. Los LLM también tienen todavía dificultades con el análisis de seguridad a fondo: CyberSOCEval, un benchmark publicado en 2025 por Meta y CrowdStrike, encontró grandes brechas en cómo los modelos actuales manejan el análisis de malware y el razonamiento sobre inteligencia de amenazas, y el benchmark está lejos de saturarse. Es una buena razón para que una persona siga revisando lo que producen.
Los LLM que se agregan al SOC son, además, sistemas nuevos que proteger. Proteger el propio LLM es un trabajo aparte, y los ataques a sistemas de IA son un tema distinto del ML que detecta ataques.
Regla, modelo o LLM: cómo elegir
Cuatro preguntas resuelven la mayoría de los casos:
- ¿Es una técnica conocida con un patrón claro? Escribe una regla, mapéala a MITRE ATT&CK, pruébala y versiónala.
- ¿Es algo inusual para este usuario o equipo? Usa una línea base o un modelo de anomalías, porque ningún umbral fijo le queda a todos.
- ¿Es una anomalía por sí sola? Deja que alimente reglas e investigaciones como contexto. Microsoft dice lo mismo: una anomalía es una señal débil, mientras que varias en distintas etapas de un ataque forman una señal clara. Una sola anomalía rara vez merece una alerta propia.
- ¿Es trabajo sobre una alerta que ya existe? Ahí va el LLM. Trabaja sobre las pocas alertas, nunca sobre los millones de eventos que las preceden.
Dónde entra GUILDA
Nuestra implementación de SIEM y detección de amenazas lleva esto a la práctica en Microsoft Sentinel, Splunk, Elastic Security o Wazuh. Conectamos las fuentes de registros que importan, escribimos reglas de detección mapeadas a MITRE ATT&CK, activamos las detecciones de anomalías de la plataforma donde convienen y las ajustamos, y entregamos todo con runbooks y un calendario de ajustes. Después, tu equipo lo opera.
Cuando la detección que necesitas depende de tus propios datos, como patrones de fraude en tus transacciones o lecturas inusuales de tu maquinaria, el modelo se construye y se entrena para ti dentro de implementación de IA y ML.
Preguntas frecuentes
¿Los LLM van a reemplazar al machine learning en la detección de amenazas?
No en la detección misma. Un SIEM ve millones de eventos al día, y cada uno debe calificarse en milisegundos, casi sin costo y con la misma respuesta cada vez. Eso lo hacen los clasificadores y los modelos de anomalías. Los LLM son útiles una vez que existe una alerta, para resumirla, redactar la consulta que la verifica o encontrar el incidente anterior que se le parece.
¿Cuánto tiempo necesita un modelo de anomalías antes de ser útil?
Necesita suficiente historial para saber qué es lo normal. Microsoft dice que sus reglas de anomalías de Sentinel suelen entrenarse de 7 a 21 días. Después, planea un ajuste semanal durante el primer mes, porque la primera línea base rara vez es correcta para cada usuario y cada equipo.
¿Necesitamos científicos de datos para usar machine learning en la detección?
Por lo general, no. La mayoría de los modelos útiles vienen dentro de las herramientas que ya usas, desde los clasificadores de malware y phishing del EDR y la seguridad de correo hasta las reglas de anomalías de tu SIEM. Lo que necesitas es alguien que los ajuste y decida para qué sirve cada uno. Un modelo entrenado con tus propios datos es otro proyecto.
¿GUILDA va a monitorear nuestras alertas?
No. Implementamos el SIEM, escribimos y ajustamos las detecciones, y las entregamos con runbooks. Después, tu equipo las opera. No operamos un centro de operaciones de seguridad ni vigilamos tus sistemas las 24 horas.
Fuentes
- SANS 2025 Detection and Response Survey: Unseen Threats Have Security Teams Rethinking Detection, SANS Institute, 2025
- Anomalies detected by the Microsoft Sentinel machine learning engine, Microsoft, 2026
- Use customizable anomalies to detect threats in Microsoft Sentinel, Microsoft, 2026
- Machine Learning Detected DGA activity using a known SUNBURST DNS domain, Elastic, 2026
- CyberSOCEval: Benchmarking LLMs Capabilities for Malware Analysis and Threat Intelligence Reasoning, Meta and CrowdStrike, 2025
Implementación de SIEM y detección de amenazas en ciberseguridad
Implementamos un SIEM, conectamos las fuentes de logs que importan, escribimos reglas de detección mapeadas a MITRE ATT&CK y entregamos la plataforma con runbooks. Después la opera tu equipo; no ofrecemos un servicio de monitoreo.
Lecturas relacionadas
Detección de amenazas
Biometría conductual con ML: PERSONA, vista multimodal de cada usuario, dispositivo y agente de IA
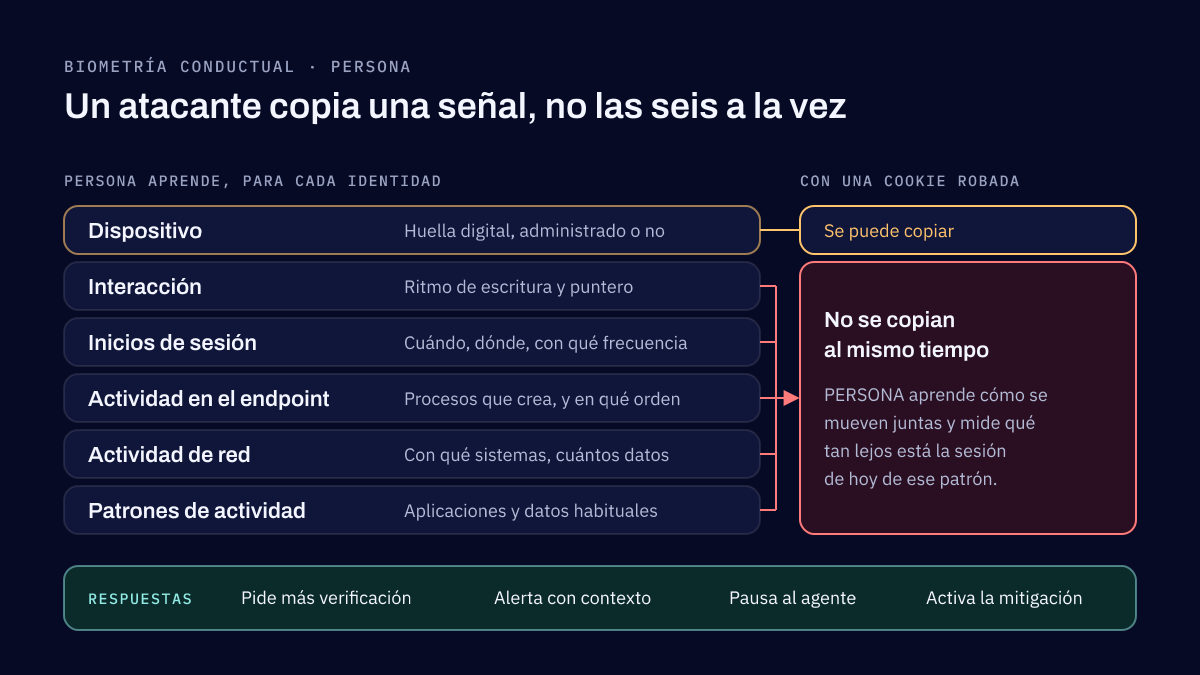
La biometría conductual identifica a un usuario por cómo actúa, no por lo que sabe o trae. Con la huella digital del dispositivo y el contexto de la sesión, y con machine learning, da un perfil que muestra cuándo una cuenta, un dispositivo o un agente de IA deja de actuar como siempre. PERSONA es nuestro nombre para ese perfil.
Detección de amenazas
Detectar bots por su ritmo: la transformada de Fourier y el análisis de frecuencia
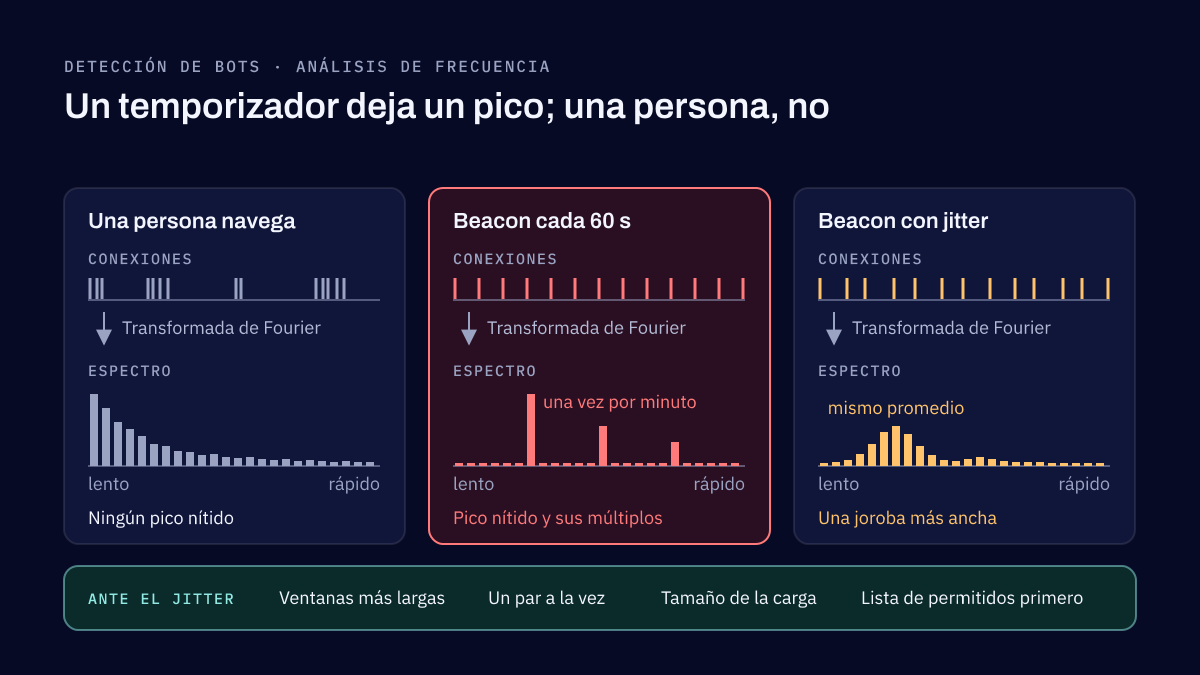
Casi toda la detección de bots juzga cada solicitud por separado, así que un bot paciente pasa. Los scripts y el malware llevan el tiempo; las personas no. Aquí explicamos cómo una transformada de Fourier convierte ese ritmo en un pico visible, cómo el jitter intenta ocultarlo y dónde encaja el ritmo junto a otras señales.
Cuéntanos qué necesitas detectar
Nombra tus sistemas y el requisito detrás del proyecto. Respondemos en un plazo de dos días hábiles.