Kubernetes y contenedores
Federación de identidades para GKE: acceso a Google Cloud sin llaves
La federación de identidades para GKE permite que una carga de Kubernetes llame a las API de Google Cloud con su propia identidad y credenciales de corta duración, sin llaves que guardar o rotar. Elimina toda una clase de credenciales filtradas, si cada carga tiene su propia identidad y solo el acceso que necesita.

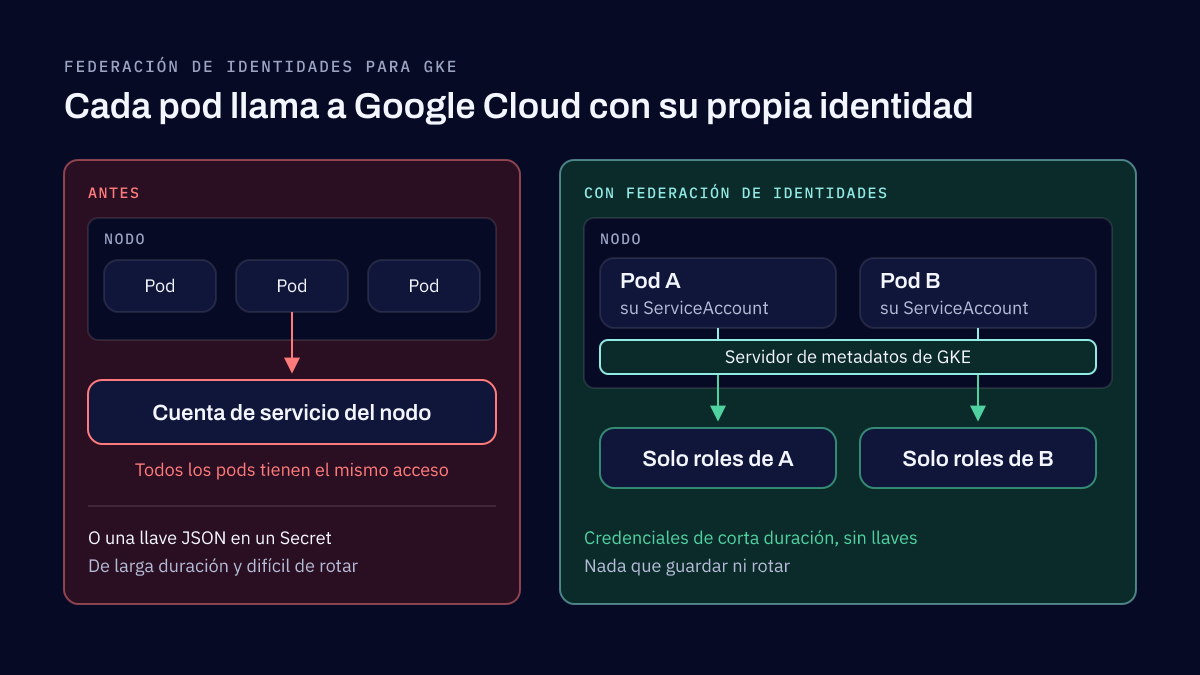
La federación de identidades para cargas de trabajo de GKE (Workload Identity Federation for GKE) permite que un pod se autentique ante las API de Google Cloud como sí mismo. Otorgas roles de IAM a la ServiceAccount de Kubernetes del pod, y GKE cambia esa identidad por credenciales de Google Cloud de corta duración cuando el pod las necesita. No se crea ninguna llave de cuenta de servicio, no se guarda en un secreto y no hay que rotarla; por eso Google la presenta como la forma recomendada para que las cargas de GKE lleguen a las API de Google Cloud.
Este artículo forma parte de nuestra serie sobre Google Cloud y Kubernetes. El panorama de buenas prácticas de seguridad de contenedores explica dónde encaja entre los demás controles.
Cómo llegaban antes las cargas a Google Cloud
En los clústeres de GKE en los que hemos trabajado, las cargas llegaban a Google Cloud de una de dos formas. Algunas usaban llaves de cuenta de servicio exportadas: un archivo JSON creado en IAM, guardado como Secret de Kubernetes o incluido en la imagen, que la aplicación leía. Otras no tenían credenciales propias y heredaban los permisos de la cuenta de servicio del nodo.
Las dos causaban los mismos tres problemas. Las llaves podían quedar expuestas, porque una llave de larga duración copiada en secretos, imágenes y laptops es tan segura como la copia peor protegida. Rotarlas era difícil, así que muchas veces no se hacía, y una llave podía seguir vigente durante años. Y los privilegios eran demasiado amplios. Con la cuenta de servicio del nodo, todos los pods del nodo tenían el mismo acceso, así que los permisos debían cubrir la carga más exigente, y un pod comprometido que no tenía nada que hacer en Cloud Storage podía usarlo de todos modos.
Cómo funciona
El clúster recibe un grupo de identidades para cargas de trabajo con el nombre del proyecto, PROJECT_ID.svc.id.goog. En cada nodo, el servidor de metadatos de GKE intercepta las solicitudes que los pods hacen al endpoint de metadatos y las responde con credenciales de la propia ServiceAccount de Kubernetes del pod, no con las del nodo.
En IAM, otorgas los roles directamente a esa ServiceAccount de Kubernetes, con un identificador de principal que nombra el proyecto, el namespace y la ServiceAccount:
principal://iam.googleapis.com/projects/PROJECT_NUMBER/locations/global/workloadIdentityPools/PROJECT_ID.svc.id.goog/subject/ns/NAMESPACE/sa/KSA_NAME
Google documenta este otorgamiento directo como el método preferido. El método anterior, vincular la ServiceAccount de Kubernetes con una cuenta de servicio de IAM, sigue disponible para las API que todavía no aceptan la forma directa. Necesita dos cosas: el rol roles/iam.workloadIdentityUser otorgado sobre la cuenta de servicio de IAM y la anotación iam.gke.io/gcp-service-account en la ServiceAccount de Kubernetes. Las dos son obligatorias.
En los clústeres Autopilot la función siempre está activa. En los clústeres Standard la activas en el clúster con --workload-pool=PROJECT_ID.svc.id.goog y en cada grupo de nodos con --workload-metadata=GKE_METADATA. Vale la pena indicar la opción del grupo de nodos de forma explícita, porque así la creación del grupo falla si el clúster no tiene la función activada, en lugar de volver en silencio a la cuenta de servicio del nodo.
Los errores que dejan el acceso demasiado abierto
Pasar a la federación de identidades elimina las llaves. Por sí sola, no te da el mínimo privilegio. Estos son los errores que vemos con más frecuencia.
Asignaciones de IAM demasiado amplias. Un rol otorgado a nivel de proyecto cuando la carga necesita un solo bucket, o un rol básico como Editor otorgado porque era más rápido. Otorga los roles sobre el recurso concreto cuando puedas y elige el rol predefinido más limitado que funcione.
Una identidad compartida por cargas sin relación. Cuando varias aplicaciones usan la misma ServiceAccount de Kubernetes, o están vinculadas a la misma cuenta de servicio de IAM, cada una carga con el acceso de todas las demás. Dale a cada carga su propia ServiceAccount, para que sus permisos describan lo que hace esa aplicación y nada más.
Aislamiento débil entre namespaces. El identificador de principal nombra el namespace y la ServiceAccount, no el clúster. Google lo llama igualdad de identidad: una ServiceAccount con el mismo namespace y el mismo nombre en dos clústeres del mismo proyecto se trata como la misma identidad y recibe el mismo acceso. Eso es útil para un servicio que corre en varios clústeres. También significa que cualquiera que pueda crear esa ServiceAccount en ese namespace, en cualquier clúster del proyecto, hereda su acceso. Controla quién puede crear ServiceAccounts y namespaces, mantén en un proyecto aparte los clústeres en los que confías menos o limita el acceso a ciertos clústeres con condiciones de IAM, como sugiere Google.
Cuándo no usarla
Recomendamos la federación de identidades como opción predeterminada. Las excepciones son límites de compatibilidad. Los pods que corren en la red del host (hostNetwork: true) no la usan. Algunas API de Google Cloud no aceptan el identificador de principal directo, y en ese caso lo correcto es la cuenta de servicio de IAM vinculada, no una llave. Google también señala límites prácticos, como unos segundos antes de que el servidor de metadatos responda a un pod recién creado, algo que importa en las cargas que llaman a una API en cuanto arrancan.
Cómo migrar un clúster
Si hoy migráramos un clúster a la federación de identidades, el orden sería este:
- Primero, audita IAM. Haz una lista de todas las llaves de cuentas de servicio, de todos los roles de la cuenta de servicio del nodo y de qué cargas dependen de cada uno. Así ves lo que cada carga usa en realidad, que suele ser menos de lo que tiene.
- Crea identidades dedicadas. Una ServiceAccount de Kubernetes por carga, cada una solo con los roles que esa carga necesita, otorgados sobre el recurso más limitado.
- Activa la función y migra las cargas una por una. En los clústeres Standard, actívala en el clúster y crea o actualiza los grupos de nodos con el servidor de metadatos de GKE.
- Prueba la autenticación antes de quitar las credenciales anteriores. Confirma que cada carga llama a las API que necesita con su nueva identidad, y solo entonces borra sus llaves y quita los roles de la cuenta de servicio del nodo.
- Sustituye la cuenta de servicio del nodo. Cuando ninguna carga dependa de ella, asigna a los nodos una cuenta de servicio dedicada y de mínimo privilegio en lugar de la predeterminada de Compute Engine.
Quitar las credenciales anteriores al final significa que un error rompe el acceso de una carga durante una prueba, y no producción después de que ya se borró una llave.
El resto de la serie
La identidad es una capa. Los Shielded GKE Nodes protegen la identidad de los propios nodos, y Binary Authorization controla qué imágenes pueden correr con estas identidades desde el principio.
Nuestro servicio de seguridad en ingeniería y DevSecOps refuerza los clústeres de GKE, incluida la forma en que se autentican las cargas, y el de seguridad de datos, aplicaciones y nube revisa y ajusta IAM en los proyectos de Google Cloud que los rodean.
Fuentes
- Authenticate to Google Cloud APIs from GKE workloads, Google Cloud, 2026
- About Workload Identity Federation for GKE, Google Cloud, 2026
- Best practices for hardening your cluster's security, Google Cloud, 2026
Consultoría DevSecOps y seguridad en el desarrollo de software
Integramos la seguridad en la forma en que tu software se diseña, se construye y se opera, desde las revisiones en tu pipeline hasta la configuración de tus clústeres de Kubernetes y los estándares de código que siguen tus desarrolladores. Todo lo que configuramos se entrega a tu equipo.
Lecturas relacionadas
Kubernetes y contenedores
Binary Authorization en GKE: una adopción que no bloquea los despliegues
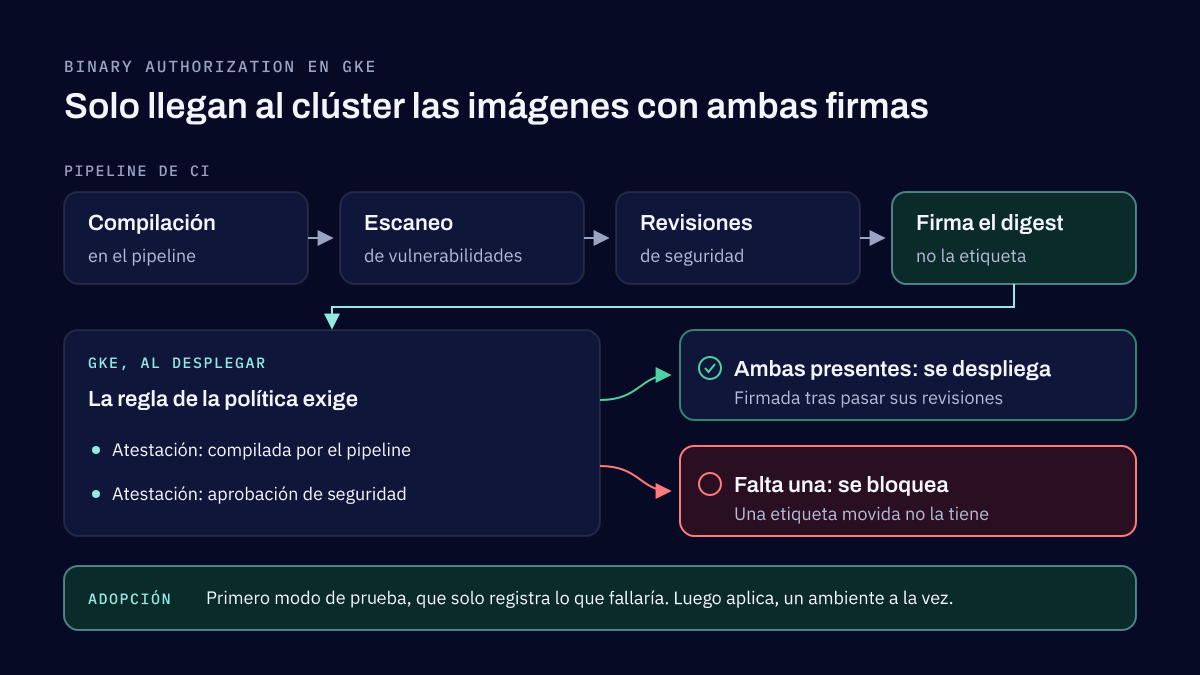
Binary Authorization hace que GKE revise cada imagen de contenedor contra una política antes de desplegarla, y solo deja correr las imágenes firmadas por los atestadores en los que confías. Empieza en modo de prueba, firma el digest de la imagen en CI cuando pasen la compilación y el escaneo, y deja las excepciones y el break-glass para emergencias reales.
Kubernetes y contenedores
Shielded GKE Nodes: qué protegen y qué no
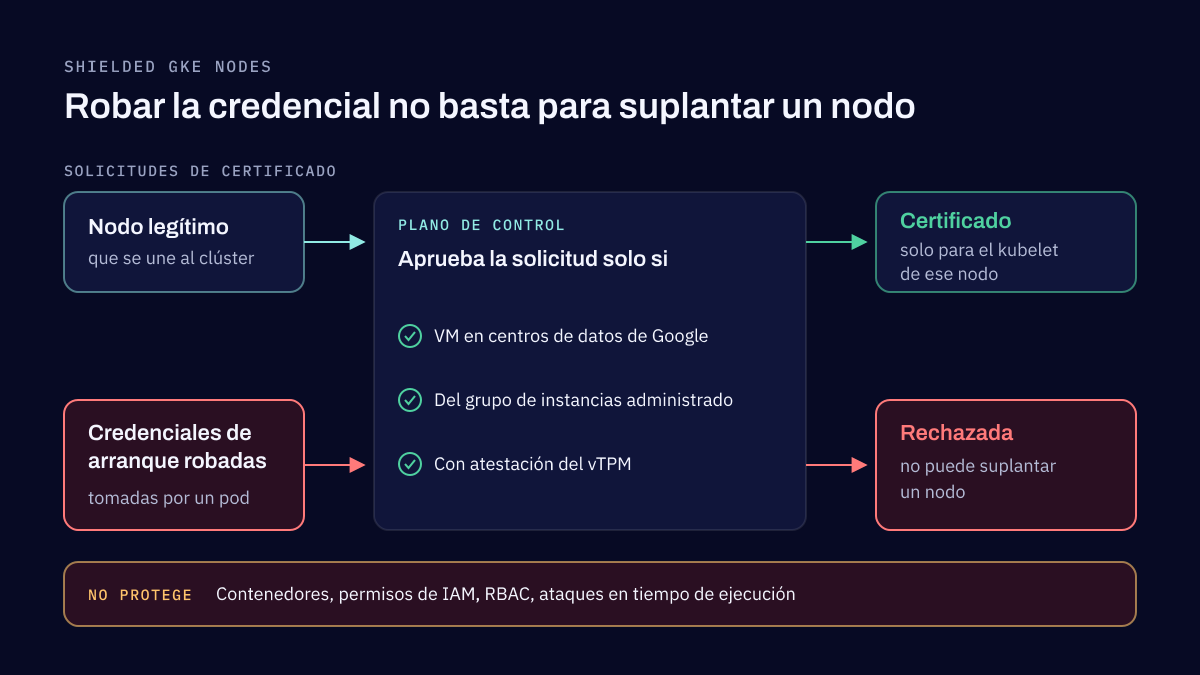
Los Shielded GKE Nodes demuestran al plano de control que cada nodo es una VM legítima de tu clúster, así que quien roba las credenciales de arranque de un nodo no puede suplantarlo. Secure Boot y la supervisión de integridad revisan cómo arrancó. Protegen el nodo, no las cargas.
Cuéntanos cómo construyes y liberas tu software
Indica los lenguajes, el pipeline y dónde corre. Respondemos en un máximo de dos días hábiles.